ONDEV Logo

Expert en acquisition client digitale. Création de sites web et applications sur-mesure qui convertissent.

Services
  • Création de Sites Web
  • Applications Sur-Mesure
  • Publicité Digitale
  • Référencement SEO
  • Développeur Web Marseille
  • Création de Logo
  • Design UX/UI
  • Refonte d'Application
  • Maintenance Applicative
  • Audit de Code
  • Agence Vibe Coding
  • Logiciel Métier Sur-Mesure
  • Agence No Code
  • Portail Client & Extranet
  • Intranet Sur-Mesure
  • Refonte Site WordPress
  • Migration Angular vers React
Navigation
  • Accueil
  • Agence web à Marseille
  • Réalisations
  • Expertise
  • Qui sommes-nous
  • Blog
  • Contact
Guides
  • Nos guides
  • Comment créer un site internet
  • Pourquoi créer un site internet
  • Coût d'un site internet
  • Choisir son prestataire web
Contact

Mathieu Rabissoni

06 01 37 20 21WhatsAppmathieu@ondev.fr

Marseille, France

Suivez-nous

LinkedInInstagramFacebook
Zones d'intervention
Marseille|Aix-en-Provence|Aubagne|La Ciotat|Cassis|Allauch|Gardanne|Marignane|Vitrolles|Toutes nos zones

© 2026 ONDEV. Tous droits réservés.

Mentions légalesPolitique de confidentialitéPlan du site
ONDEV Logo
Réalisations
Contact
On en discute

Expertise

Création de Sites WebSite Vitrine MarseilleSite E-Commerce MarseilleRéférencement SEOOptimisation GEOApplications Web & MobileAgence CommunicationPublicité en LigneDéveloppeur Web Marseille
Réalisations

Ressources

Qui sommes-nous ?BlogGuides
Contact
AppelerWhatsApp
On en discute
  1. Accueil
  2. Blog
  3. Code legacy : coût réel et quand réécrire
Développement
24 octobre 202611 mn

Code legacy : coût réel et quand réécrire

Le code legacy coûte plus qu'il n'y paraît : temps perdu, recrutement, pannes, décote à la revente. Grille de décision : reprendre, réécrire ou laisser.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Code legacy : coût réel et quand réécrire

Sommaire

01.Votre code legacy vous coûte déjà plus cher qu'une réécriture. Ou pas.02.Qu'est-ce que le code legacy, vraiment ?03.Une définition qui ne parle pas d'âge04.Les trois formes du legacy05.Le coût réel du code legacy : trois postes que personne ne budgète06.1. Le temps de développement07.2. Le coût de recrutement08.3. Le risque de panne09.Le legacy comme décote de valorisation10.Reprendre par étapes, réécrire ou ne rien faire : la grille de décision11.Quand ne rien faire12.Quand reprendre par étapes13.Quand réécrire (et pourquoi c'est rare)14.Le cas SNEF : une reprise ciblée, un gain mesuré15.Les erreurs qui transforment un legacy gérable en passif16.FAQ : code legacy, refactoring et réécriture17.Conclusion : le legacy se chiffre, puis se traite par étapes

Votre code legacy vous coûte déjà plus cher qu'une réécriture. Ou pas.

Une application qui tourne depuis huit ans, que plus personne n'ose toucher, et un prestataire qui propose de « tout refaire à zéro » pour un montant à cinq chiffres. C'est la situation la plus fréquente que nous rencontrons quand un dirigeant nous parle de code legacy. Et dans la majorité des cas, la réponse proposée est la mauvaise.

Le legacy n'est pas un problème de développeurs. C'est un problème de valeur : il ralentit chaque évolution, renchérit chaque recrutement, et se transforme en décote le jour où vous voulez vendre, lever ou faire auditer votre actif logiciel.

Dans cet article, vous allez découvrir :

  • •Ce qu'est vraiment le code legacy (et pourquoi l'âge du code n'a rien à voir)
  • •Les trois postes de coût que personne ne budgète : temps de développement, recrutement, risque de panne
  • •Comment un acquéreur transforme votre legacy en décote de valorisation
  • •La grille de décision pour choisir entre reprise par étapes, réécriture et statu quo
  • •Le cas SNEF : une reprise ciblée qui fait gagner 1h30 tous les deux jours
La réécriture totale est la réponse la plus chère et la plus risquée au problème du legacy. C'est aussi, presque toujours, la mauvaise.

Qu'est-ce que le code legacy, vraiment ?

Une définition qui ne parle pas d'âge

Le réflexe est de définir le legacy informatique par son ancienneté : du PHP 5, du jQuery, un AS400. C'est une erreur de lecture. Nous auditons régulièrement des applications de deux ans qui sont déjà du legacy, et des bases de dix ans parfaitement maintenables.

La définition utile est celle-ci : du code legacy est du code que l'on a peur de modifier. Peur parce qu'il n'y a pas de tests, parce que la personne qui l'a écrit est partie, parce que personne ne sait ce qui va casser ailleurs quand on touche ici.

Cette peur a un coût mesurable. Elle allonge chaque évolution, elle pousse les équipes à contourner plutôt qu'à corriger, et elle fait grossir la dette technique jusqu'au point où l'outil devient un passif.

Les trois formes du legacy

Dans une application legacy, le problème se présente rarement sous une seule forme. On retrouve en général une combinaison de trois couches :

  • •Le legacy de stack : framework en fin de vie, version de langage plus maintenue, dépendances abandonnées. C'est le plus visible, et paradoxalement le moins grave.
  • •Le legacy de structure : code non testé, couplage fort, logique métier éparpillée, absence de documentation. C'est celui qui coûte le plus cher au quotidien.
  • •Le legacy de connaissance : une seule personne (ou aucune) comprend encore comment l'application fonctionne. C'est celui qui fait peur à un acquéreur.

Notre guide de la dette technique détaille comment ces couches s'accumulent et comment les mesurer. Ici, nous nous concentrons sur ce qu'elles coûtent.

Le coût réel du code legacy : trois postes que personne ne budgète

Le coût du legacy n'apparaît sur aucune facture. Il est dilué dans les délais, les salaires et les incidents. C'est précisément pour cela qu'il est sous-estimé. Voici les trois postes à chiffrer, avec les ordres de grandeur que nous observons en audit.

1. Le temps de développement

Sur une base saine, une évolution simple se livre en quelques jours. Sur un legacy sans tests et sans documentation, la même évolution demande d'abord de comprendre le code, puis de le modifier à l'aveugle, puis de tester à la main tout ce qui aurait pu casser.

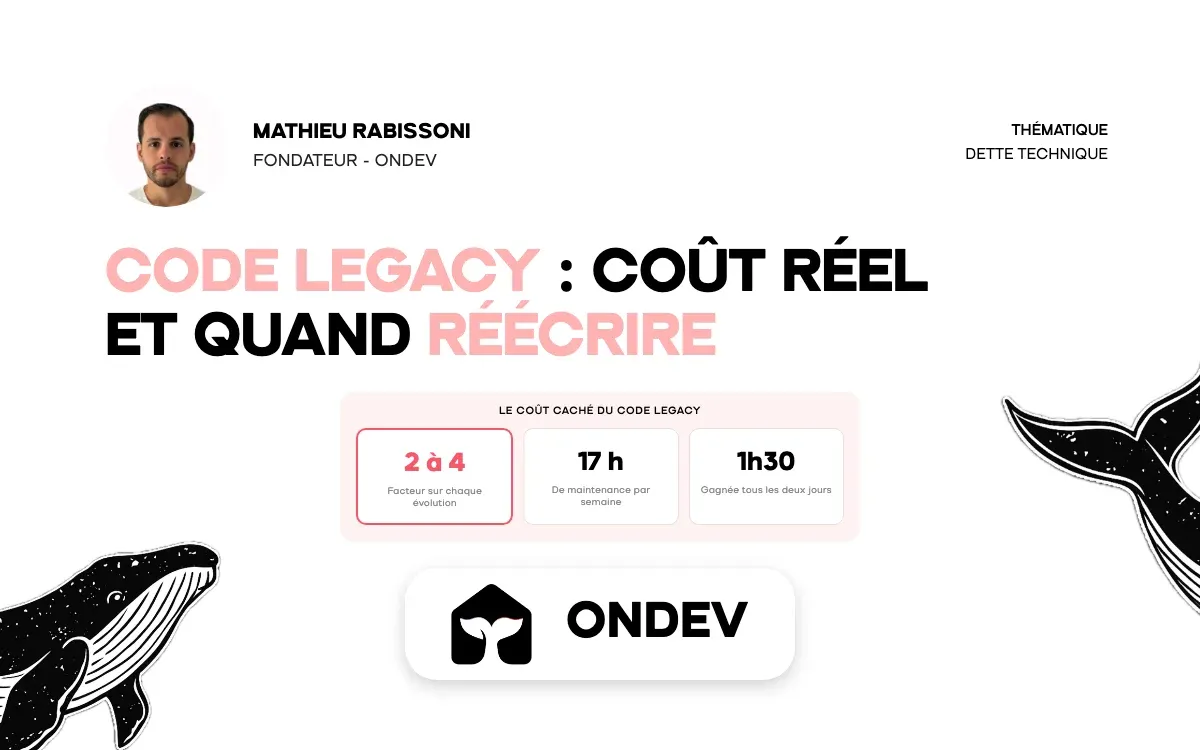
Le facteur multiplicateur que nous constatons le plus souvent se situe entre deux et quatre. Autrement dit, une équipe sur un legacy lourd produit moitié moins, pour le même budget, qu'une équipe sur une base propre. Et ce ratio se dégrade avec le temps.

Ce constat n'est pas propre à nos audits. L'étude The Developer Coefficient publiée par Stripe estime que les développeurs passent environ 17 heures par semaine en maintenance : débogage, refactoring, correction de mauvais code (source). Près de la moitié du temps payé ne produit rien de nouveau.

2. Le coût de recrutement

Un développeur compétent choisit ses missions. Proposez-lui une stack morte, sans tests, sans CI, et il décline, ou il demande une prime. Les profils qui acceptent sont soit en fin de carrière sur la technologie, soit juniors et sous-encadrés.

Le résultat est double : le recrutement prend plusieurs mois de plus, et le turnover est plus élevé. Chaque départ emporte une partie de la connaissance de l'application, ce qui aggrave le legacy de connaissance et relance le cycle.

3. Le risque de panne

Le dernier poste est le plus difficile à budgéter parce qu'il est probabiliste. Une application legacy a trois caractéristiques qui concentrent le risque : des dépendances non patchées (faille de sécurité), un hébergement figé parce que personne n'ose migrer (panne d'infrastructure), et une absence de tests (régression à chaque livraison).

La question à se poser n'est pas « est-ce que ça peut tomber ? », mais « combien coûte une journée d'arrêt, et combien de jours nous faudrait-il pour redémarrer sans la personne qui connaît le code ? ».

Poste de coûtCe qu'il cacheOrdre de grandeur observé
Temps de développementCompréhension, modification à l'aveugle, tests manuelsFacteur 2 à 4 sur chaque évolution
RecrutementRareté des profils, primes, turnover, perte de connaissancePlusieurs mois de délai par poste
Risque de panneFailles non patchées, infra figée, régressionsUn arrêt dont la durée dépend d'une seule personne

Le legacy comme décote de valorisation

Tant que vous exploitez l'application, ces coûts sont diffus. Le jour où vous la vendez, où vous levez des fonds ou où vous intégrez un groupe, ils deviennent explicites : un acquéreur ne voit pas du code legacy, il voit un budget de reprise à déduire du prix.

C'est exactement le travail d'une due diligence technique : lire le code, chiffrer ce qu'il faudrait pour le rendre maintenable et sécurisé, et traduire ce chiffre en conditions de deal. Trois mécanismes reviennent systématiquement :

  • •La décote directe : le coût estimé de la reprise est soustrait de la valorisation, souvent avec une marge de sécurité.
  • •La garantie de passif : le vendeur s'engage à couvrir les incidents techniques découverts après la vente.
  • •La dépendance aux personnes clés : si un seul développeur comprend le système, l'acquéreur exige sa rétention, ce qui conditionne une partie du prix.

Le point à retenir : le legacy que vous ne traitez pas, c'est l'acquéreur qui le chiffre à votre place, avec ses propres hypothèses, et jamais à votre avantage. Un vendeur qui arrive avec un diagnostic de dette technique et un plan de reprise déjà engagé reprend la main sur cette discussion.

Reprendre par étapes, réécrire ou ne rien faire : la grille de décision

Face à un legacy, il existe trois voies. Pas quatre, pas deux. Et la voie que l'on vous propose le plus souvent, la réécriture totale, est celle qui convient dans le moins de situations.

SituationSignauxVoie recommandée
L'application est stable, peu modifiée, sans exposition sécuritéMoins d'une évolution par trimestre, dépendances patchées, pas de données sensiblesNe rien faire, surveiller
L'application évolue, mais chaque livraison est lente et risquéeDélais qui s'allongent, régressions fréquentes, recrutement difficileReprise par étapes
Le métier a changé, le code ne correspond plus à ce que fait l'entrepriseFonctionnalités contournées, données dupliquées ailleurs, périmètre à redéfinirRéécriture ciblée, après cadrage

Quand ne rien faire

C'est l'option la plus sous-estimée. Une application legacy qui fait son travail, qui n'évolue pas et qui n'expose aucune surface d'attaque n'a pas besoin d'être modernisée. Elle a besoin d'être surveillée : dépendances mises à jour, sauvegardes testées, documentation minimale pour qu'une deuxième personne puisse intervenir.

Dépenser un budget de refonte sur un outil qui ne bouge pas, c'est détruire de la valeur pour le confort de dire que l'on est « à jour ».

Quand reprendre par étapes

C'est la voie la plus fréquente et la plus rentable. Le refactoring legacy par étapes consiste à isoler le périmètre qui coûte le plus cher (le module le plus modifié, le plus bogué ou le plus exposé) et à le reprendre en premier, tout en laissant le reste en production.

Concrètement, cela ressemble à ceci :

  1. 1.Cartographier : quels modules concentrent les évolutions et les incidents des douze derniers mois ?
  2. 2.Sécuriser : mettre des tests autour du périmètre ciblé avant de le toucher, pour détecter les régressions.
  3. 3.Reprendre un module : le réécrire ou le refactorer, le déployer, mesurer.
  4. 4.Itérer : passer au module suivant, uniquement si le gain mesuré le justifie.

Chaque étape produit un résultat exploitable. Si le budget s'arrête au bout de trois mois, vous avez trois mois de progrès en production, pas un chantier à moitié fini. C'est la logique que nous appliquons dans nos projets de refonte d'application web et de migration d'application PHP : la stack change, mais jamais d'un seul bloc.

Quand réécrire (et pourquoi c'est rare)

La réécriture se justifie dans un cas précis : quand le code ne décrit plus le métier. L'entreprise a changé de modèle, les processus ont été réinventés, et l'application actuelle est contournée par des tableurs et des outils parallèles. Là, reprendre module par module revient à restaurer une maison dont on va changer les fondations.

Même dans ce cas, la réécriture n'est jamais totale au sens où on l'entend d'habitude. Elle se fait par périmètre fonctionnel, avec l'ancien système qui reste en production jusqu'à ce que le nouveau le remplace, bloc par bloc.

Notre position est ferme, et elle correspond au critère 10 de notre diagnostic de dette technique : un devis de réécriture totale sans cartographie préalable est un signal d'alarme, pas une solution. Il annonce en général un chantier deux fois plus long que prévu, un gel des évolutions pendant toute sa durée, et une application neuve qui reproduit les défauts de l'ancienne parce que personne n'a pris le temps de comprendre pourquoi elle était faite ainsi.

Le cas SNEF : une reprise ciblée, un gain mesuré

Le projet que nous avons mené pour SNEF illustre la logique de la reprise par périmètre. Le besoin portait sur la visualisation de schémas électriques, un processus technique sur lequel les équipes perdaient du temps à chaque consultation.

Plutôt que de repenser l'ensemble de l'outillage, nous avons isolé ce périmètre précis et l'avons repris sur une base moderne : Next.js, TypeScript, PostgreSQL et Prisma, en self-hosting pour rester dans le cadre de sécurité d'un industriel.

Le résultat se mesure simplement : 1h30 gagnée tous les deux jours sur le processus, et une visibilité projet complète pour les équipes. Pas de chantier de dix-huit mois, pas de gel des opérations, un périmètre repris et un gain chiffré. Découvrir la réalisation SNEF.

C'est ce que nous entendons par reprise réussie : pas la stack la plus récente, mais un coût réel qui baisse et une valeur qui remonte, étape après étape.

Les erreurs qui transforment un legacy gérable en passif

  • •Signer une réécriture totale sans cartographie. C'est le critère 10. Si le prestataire n'a pas lu le code avant de chiffrer, le chiffre ne vaut rien.
  • •Laisser une seule personne détenir la connaissance. Documenter et faire intervenir une deuxième personne coûte quelques jours ; perdre le seul sachant coûte des mois.
  • •Geler les dépendances « parce que ça marche ». Les mises à jour de sécurité ne sont pas optionnelles. Plus on attend, plus le saut de version devient un projet en soi.
  • •Reprendre d'abord ce qui est le plus moche, pas ce qui coûte le plus cher. Le refactoring doit suivre les incidents et les évolutions, pas l'esthétique du code.
  • •Mesurer la modernité au lieu de mesurer le coût. La question n'est pas « sommes-nous sur la dernière version ? », mais « combien nous coûte une évolution, et combien coûtait-elle il y a un an ? ».
  • •Attendre la vente pour s'en occuper. Au moment de la due diligence, il est trop tard pour négocier : l'acquéreur chiffre, vous subissez.

FAQ : code legacy, refactoring et réécriture

Pour chiffrer ces trois postes sur votre propre base de code, notre audit de code livre un plan d'action priorisé, avec un coût en jours pour chaque chantier.

Qu'est-ce que le code legacy ?
Le code legacy est du code que l'on a peur de modifier : sans tests, sans documentation, ou dont l'auteur est parti. L'âge n'est pas le critère. Une application de deux ans peut être du legacy, une base de dix ans peut être saine. Ce qui compte, c'est le coût et le risque de chaque modification.
Combien coûte réellement le code legacy à une entreprise ?
Le coût est dilué dans trois postes : le temps de développement (facteur 2 à 4 sur chaque évolution dans nos audits), le recrutement (profils rares, délais, turnover) et le risque de panne (failles non patchées, dépendance à une seule personne). À la revente, ces coûts deviennent une décote de valorisation chiffrée par l'acquéreur.
Faut-il réécrire une application legacy ?
Rarement. La réécriture totale se justifie seulement quand le code ne décrit plus le métier de l'entreprise. Dans la majorité des cas, une reprise par étapes du périmètre critique produit le même résultat pour une fraction du budget, sans geler les évolutions. Un devis de réécriture totale sans cartographie préalable est un signal d'alarme.
Quelle différence entre refactoring legacy et réécriture ?
Le refactoring améliore la structure du code existant sans changer son comportement, module par module, avec l'application qui reste en production. La réécriture repart d'une page blanche sur un périmètre donné. Le refactoring est l'outil par défaut ; la réécriture est l'exception, réservée aux périmètres dont la logique métier a changé.
Comment préparer une application legacy à une vente ou une levée de fonds ?
Commencez par un diagnostic de dette technique pour objectiver l'état du code, puis engagez une reprise par étapes sur les points qui pèseront le plus en due diligence technique : sécurité, tests, documentation, dépendance aux personnes clés. Un vendeur qui arrive avec un plan déjà engagé garde la main sur la négociation.

Conclusion : le legacy se chiffre, puis se traite par étapes

Le code legacy n'est pas une fatalité technique, c'est une ligne de coût et une décote de valorisation qui attendent d'être chiffrées. Une fois chiffrées, la décision devient simple : surveiller ce qui ne bouge pas, reprendre par étapes ce qui coûte cher, réécrire uniquement ce qui ne décrit plus votre métier.

La réécriture totale par défaut reste l'erreur la plus coûteuse que nous voyons. Avant de signer un devis de ce type, faites lire le code par quelqu'un qui n'a pas intérêt à tout refaire.


Vous avez une application legacy et un devis de réécriture sur la table ? Parlons-en avant que vous signiez : nous lisons le code, nous chiffrons les trois postes de coût et nous vous disons laquelle des trois voies est la bonne.
Auteur

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

Infos

24 octobre 2026
11 mn
Développement

Service lié

Création site internet

Site sur-mesure avec SEO intégré, livré en 30 jours.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

  • Sans dépendance technique
  • Sans frais de maintenance inutiles
On en discute ?

Avec nous c'est simple, rien n'est compliqué !

Nos réalisations

Refonte & SEO - Amadeus Centre d’Affaires
Refonte & Stratégie SEO

Refonte & SEO - Amadeus Centre d’Affaires

Wiloq - Application SaaS Vestiaire Numérique
Application SaaS

Wiloq - Application SaaS Vestiaire Numérique

Voir toutes les réalisations

Votre code legacy vous coûte déjà plus cher qu'une réécriture. Ou pas.

Une application qui tourne depuis huit ans, que plus personne n'ose toucher, et un prestataire qui propose de « tout refaire à zéro » pour un montant à cinq chiffres. C'est la situation la plus fréquente que nous rencontrons quand un dirigeant nous parle de code legacy. Et dans la majorité des cas, la réponse proposée est la mauvaise.

Le legacy n'est pas un problème de développeurs. C'est un problème de valeur : il ralentit chaque évolution, renchérit chaque recrutement, et se transforme en décote le jour où vous voulez vendre, lever ou faire auditer votre actif logiciel.

Dans cet article, vous allez découvrir :

  • •Ce qu'est vraiment le code legacy (et pourquoi l'âge du code n'a rien à voir)
  • •Les trois postes de coût que personne ne budgète : temps de développement, recrutement, risque de panne
  • •Comment un acquéreur transforme votre legacy en décote de valorisation
  • •La grille de décision pour choisir entre reprise par étapes, réécriture et statu quo
  • •Le cas SNEF : une reprise ciblée qui fait gagner 1h30 tous les deux jours
La réécriture totale est la réponse la plus chère et la plus risquée au problème du legacy. C'est aussi, presque toujours, la mauvaise.

Qu'est-ce que le code legacy, vraiment ?

Une définition qui ne parle pas d'âge

Le réflexe est de définir le legacy informatique par son ancienneté : du PHP 5, du jQuery, un AS400. C'est une erreur de lecture. Nous auditons régulièrement des applications de deux ans qui sont déjà du legacy, et des bases de dix ans parfaitement maintenables.

La définition utile est celle-ci : du code legacy est du code que l'on a peur de modifier. Peur parce qu'il n'y a pas de tests, parce que la personne qui l'a écrit est partie, parce que personne ne sait ce qui va casser ailleurs quand on touche ici.

Cette peur a un coût mesurable. Elle allonge chaque évolution, elle pousse les équipes à contourner plutôt qu'à corriger, et elle fait grossir la dette technique jusqu'au point où l'outil devient un passif.

Les trois formes du legacy

Dans une application legacy, le problème se présente rarement sous une seule forme. On retrouve en général une combinaison de trois couches :

  • •Le legacy de stack : framework en fin de vie, version de langage plus maintenue, dépendances abandonnées. C'est le plus visible, et paradoxalement le moins grave.
  • •Le legacy de structure : code non testé, couplage fort, logique métier éparpillée, absence de documentation. C'est celui qui coûte le plus cher au quotidien.
  • •Le legacy de connaissance : une seule personne (ou aucune) comprend encore comment l'application fonctionne. C'est celui qui fait peur à un acquéreur.

Notre guide de la dette technique détaille comment ces couches s'accumulent et comment les mesurer. Ici, nous nous concentrons sur ce qu'elles coûtent.

Le coût réel du code legacy : trois postes que personne ne budgète

Le coût du legacy n'apparaît sur aucune facture. Il est dilué dans les délais, les salaires et les incidents. C'est précisément pour cela qu'il est sous-estimé. Voici les trois postes à chiffrer, avec les ordres de grandeur que nous observons en audit.

1. Le temps de développement

Sur une base saine, une évolution simple se livre en quelques jours. Sur un legacy sans tests et sans documentation, la même évolution demande d'abord de comprendre le code, puis de le modifier à l'aveugle, puis de tester à la main tout ce qui aurait pu casser.

Le facteur multiplicateur que nous constatons le plus souvent se situe entre deux et quatre. Autrement dit, une équipe sur un legacy lourd produit moitié moins, pour le même budget, qu'une équipe sur une base propre. Et ce ratio se dégrade avec le temps.

Ce constat n'est pas propre à nos audits. L'étude The Developer Coefficient publiée par Stripe estime que les développeurs passent environ 17 heures par semaine en maintenance : débogage, refactoring, correction de mauvais code (source). Près de la moitié du temps payé ne produit rien de nouveau.

2. Le coût de recrutement

Un développeur compétent choisit ses missions. Proposez-lui une stack morte, sans tests, sans CI, et il décline, ou il demande une prime. Les profils qui acceptent sont soit en fin de carrière sur la technologie, soit juniors et sous-encadrés.

Le résultat est double : le recrutement prend plusieurs mois de plus, et le turnover est plus élevé. Chaque départ emporte une partie de la connaissance de l'application, ce qui aggrave le legacy de connaissance et relance le cycle.

3. Le risque de panne

Le dernier poste est le plus difficile à budgéter parce qu'il est probabiliste. Une application legacy a trois caractéristiques qui concentrent le risque : des dépendances non patchées (faille de sécurité), un hébergement figé parce que personne n'ose migrer (panne d'infrastructure), et une absence de tests (régression à chaque livraison).

La question à se poser n'est pas « est-ce que ça peut tomber ? », mais « combien coûte une journée d'arrêt, et combien de jours nous faudrait-il pour redémarrer sans la personne qui connaît le code ? ».

Poste de coûtCe qu'il cacheOrdre de grandeur observé
Temps de développementCompréhension, modification à l'aveugle, tests manuelsFacteur 2 à 4 sur chaque évolution
RecrutementRareté des profils, primes, turnover, perte de connaissancePlusieurs mois de délai par poste
Risque de panneFailles non patchées, infra figée, régressionsUn arrêt dont la durée dépend d'une seule personne

Le legacy comme décote de valorisation

Tant que vous exploitez l'application, ces coûts sont diffus. Le jour où vous la vendez, où vous levez des fonds ou où vous intégrez un groupe, ils deviennent explicites : un acquéreur ne voit pas du code legacy, il voit un budget de reprise à déduire du prix.

C'est exactement le travail d'une due diligence technique : lire le code, chiffrer ce qu'il faudrait pour le rendre maintenable et sécurisé, et traduire ce chiffre en conditions de deal. Trois mécanismes reviennent systématiquement :

  • •La décote directe : le coût estimé de la reprise est soustrait de la valorisation, souvent avec une marge de sécurité.
  • •La garantie de passif : le vendeur s'engage à couvrir les incidents techniques découverts après la vente.
  • •La dépendance aux personnes clés : si un seul développeur comprend le système, l'acquéreur exige sa rétention, ce qui conditionne une partie du prix.

Le point à retenir : le legacy que vous ne traitez pas, c'est l'acquéreur qui le chiffre à votre place, avec ses propres hypothèses, et jamais à votre avantage. Un vendeur qui arrive avec un diagnostic de dette technique et un plan de reprise déjà engagé reprend la main sur cette discussion.

Reprendre par étapes, réécrire ou ne rien faire : la grille de décision

Face à un legacy, il existe trois voies. Pas quatre, pas deux. Et la voie que l'on vous propose le plus souvent, la réécriture totale, est celle qui convient dans le moins de situations.

SituationSignauxVoie recommandée
L'application est stable, peu modifiée, sans exposition sécuritéMoins d'une évolution par trimestre, dépendances patchées, pas de données sensiblesNe rien faire, surveiller
L'application évolue, mais chaque livraison est lente et risquéeDélais qui s'allongent, régressions fréquentes, recrutement difficileReprise par étapes
Le métier a changé, le code ne correspond plus à ce que fait l'entrepriseFonctionnalités contournées, données dupliquées ailleurs, périmètre à redéfinirRéécriture ciblée, après cadrage

Quand ne rien faire

C'est l'option la plus sous-estimée. Une application legacy qui fait son travail, qui n'évolue pas et qui n'expose aucune surface d'attaque n'a pas besoin d'être modernisée. Elle a besoin d'être surveillée : dépendances mises à jour, sauvegardes testées, documentation minimale pour qu'une deuxième personne puisse intervenir.

Dépenser un budget de refonte sur un outil qui ne bouge pas, c'est détruire de la valeur pour le confort de dire que l'on est « à jour ».

Quand reprendre par étapes

C'est la voie la plus fréquente et la plus rentable. Le refactoring legacy par étapes consiste à isoler le périmètre qui coûte le plus cher (le module le plus modifié, le plus bogué ou le plus exposé) et à le reprendre en premier, tout en laissant le reste en production.

Concrètement, cela ressemble à ceci :

  1. 1.Cartographier : quels modules concentrent les évolutions et les incidents des douze derniers mois ?
  2. 2.Sécuriser : mettre des tests autour du périmètre ciblé avant de le toucher, pour détecter les régressions.
  3. 3.Reprendre un module : le réécrire ou le refactorer, le déployer, mesurer.
  4. 4.Itérer : passer au module suivant, uniquement si le gain mesuré le justifie.

Chaque étape produit un résultat exploitable. Si le budget s'arrête au bout de trois mois, vous avez trois mois de progrès en production, pas un chantier à moitié fini. C'est la logique que nous appliquons dans nos projets de refonte d'application web et de migration d'application PHP : la stack change, mais jamais d'un seul bloc.

Quand réécrire (et pourquoi c'est rare)

La réécriture se justifie dans un cas précis : quand le code ne décrit plus le métier. L'entreprise a changé de modèle, les processus ont été réinventés, et l'application actuelle est contournée par des tableurs et des outils parallèles. Là, reprendre module par module revient à restaurer une maison dont on va changer les fondations.

Même dans ce cas, la réécriture n'est jamais totale au sens où on l'entend d'habitude. Elle se fait par périmètre fonctionnel, avec l'ancien système qui reste en production jusqu'à ce que le nouveau le remplace, bloc par bloc.

Notre position est ferme, et elle correspond au critère 10 de notre diagnostic de dette technique : un devis de réécriture totale sans cartographie préalable est un signal d'alarme, pas une solution. Il annonce en général un chantier deux fois plus long que prévu, un gel des évolutions pendant toute sa durée, et une application neuve qui reproduit les défauts de l'ancienne parce que personne n'a pris le temps de comprendre pourquoi elle était faite ainsi.

Le cas SNEF : une reprise ciblée, un gain mesuré

Le projet que nous avons mené pour SNEF illustre la logique de la reprise par périmètre. Le besoin portait sur la visualisation de schémas électriques, un processus technique sur lequel les équipes perdaient du temps à chaque consultation.

Plutôt que de repenser l'ensemble de l'outillage, nous avons isolé ce périmètre précis et l'avons repris sur une base moderne : Next.js, TypeScript, PostgreSQL et Prisma, en self-hosting pour rester dans le cadre de sécurité d'un industriel.

Le résultat se mesure simplement : 1h30 gagnée tous les deux jours sur le processus, et une visibilité projet complète pour les équipes. Pas de chantier de dix-huit mois, pas de gel des opérations, un périmètre repris et un gain chiffré. Découvrir la réalisation SNEF.

C'est ce que nous entendons par reprise réussie : pas la stack la plus récente, mais un coût réel qui baisse et une valeur qui remonte, étape après étape.

Les erreurs qui transforment un legacy gérable en passif

  • •Signer une réécriture totale sans cartographie. C'est le critère 10. Si le prestataire n'a pas lu le code avant de chiffrer, le chiffre ne vaut rien.
  • •Laisser une seule personne détenir la connaissance. Documenter et faire intervenir une deuxième personne coûte quelques jours ; perdre le seul sachant coûte des mois.
  • •Geler les dépendances « parce que ça marche ». Les mises à jour de sécurité ne sont pas optionnelles. Plus on attend, plus le saut de version devient un projet en soi.
  • •Reprendre d'abord ce qui est le plus moche, pas ce qui coûte le plus cher. Le refactoring doit suivre les incidents et les évolutions, pas l'esthétique du code.
  • •Mesurer la modernité au lieu de mesurer le coût. La question n'est pas « sommes-nous sur la dernière version ? », mais « combien nous coûte une évolution, et combien coûtait-elle il y a un an ? ».
  • •Attendre la vente pour s'en occuper. Au moment de la due diligence, il est trop tard pour négocier : l'acquéreur chiffre, vous subissez.

FAQ : code legacy, refactoring et réécriture

Pour chiffrer ces trois postes sur votre propre base de code, notre audit de code livre un plan d'action priorisé, avec un coût en jours pour chaque chantier.

Qu'est-ce que le code legacy ?
Le code legacy est du code que l'on a peur de modifier : sans tests, sans documentation, ou dont l'auteur est parti. L'âge n'est pas le critère. Une application de deux ans peut être du legacy, une base de dix ans peut être saine. Ce qui compte, c'est le coût et le risque de chaque modification.
Combien coûte réellement le code legacy à une entreprise ?
Le coût est dilué dans trois postes : le temps de développement (facteur 2 à 4 sur chaque évolution dans nos audits), le recrutement (profils rares, délais, turnover) et le risque de panne (failles non patchées, dépendance à une seule personne). À la revente, ces coûts deviennent une décote de valorisation chiffrée par l'acquéreur.
Faut-il réécrire une application legacy ?
Rarement. La réécriture totale se justifie seulement quand le code ne décrit plus le métier de l'entreprise. Dans la majorité des cas, une reprise par étapes du périmètre critique produit le même résultat pour une fraction du budget, sans geler les évolutions. Un devis de réécriture totale sans cartographie préalable est un signal d'alarme.
Quelle différence entre refactoring legacy et réécriture ?
Le refactoring améliore la structure du code existant sans changer son comportement, module par module, avec l'application qui reste en production. La réécriture repart d'une page blanche sur un périmètre donné. Le refactoring est l'outil par défaut ; la réécriture est l'exception, réservée aux périmètres dont la logique métier a changé.
Comment préparer une application legacy à une vente ou une levée de fonds ?
Commencez par un diagnostic de dette technique pour objectiver l'état du code, puis engagez une reprise par étapes sur les points qui pèseront le plus en due diligence technique : sécurité, tests, documentation, dépendance aux personnes clés. Un vendeur qui arrive avec un plan déjà engagé garde la main sur la négociation.

Conclusion : le legacy se chiffre, puis se traite par étapes

Le code legacy n'est pas une fatalité technique, c'est une ligne de coût et une décote de valorisation qui attendent d'être chiffrées. Une fois chiffrées, la décision devient simple : surveiller ce qui ne bouge pas, reprendre par étapes ce qui coûte cher, réécrire uniquement ce qui ne décrit plus votre métier.

La réécriture totale par défaut reste l'erreur la plus coûteuse que nous voyons. Avant de signer un devis de ce type, faites lire le code par quelqu'un qui n'a pas intérêt à tout refaire.


Vous avez une application legacy et un devis de réécriture sur la table ? Parlons-en avant que vous signiez : nous lisons le code, nous chiffrons les trois postes de coût et nous vous disons laquelle des trois voies est la bonne.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

24 octobre 2026
11 mn
Développement

Service lié

Création site internet

Site sur-mesure avec SEO intégré, livré en 30 jours.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

On en discute ?
Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Passionné par le web depuis toujours, j'aide les entreprises à acquérir des clients grâce au digital. Sites web, applications, SEO : je transforme vos idées en solutions performantes.

En savoir plus

Services ONDEV liés à cet article

Création site internet Marseille•Application web sur-mesure•Refonte de site internet•Expert Next.js Marseille•Agence web à Marseille•Nos réalisations

Besoin d'aide pour votre projet ?

Discutons de vos objectifs et voyons comment je peux vous aider à les atteindre.

Prendre rendez-vousAppelerWhatsApp