ONDEV Logo

Expert en acquisition client digitale. Création de sites web et applications sur-mesure qui convertissent.

Services
  • Création de Sites Web
  • Applications Sur-Mesure
  • Publicité Digitale
  • Référencement SEO
  • Développeur Web Marseille
  • Création de Logo
  • Design UX/UI
  • Refonte d'Application
  • Maintenance Applicative
  • Audit de Code
  • Agence Vibe Coding
  • Logiciel Métier Sur-Mesure
  • Agence No Code
  • Portail Client & Extranet
  • Intranet Sur-Mesure
  • Refonte Site WordPress
  • Migration Angular vers React
Navigation
  • Accueil
  • Agence web à Marseille
  • Réalisations
  • Expertise
  • Qui sommes-nous
  • Blog
  • Contact
Guides
  • Nos guides
  • Comment créer un site internet
  • Pourquoi créer un site internet
  • Coût d'un site internet
  • Choisir son prestataire web
Contact

Mathieu Rabissoni

06 01 37 20 21WhatsAppmathieu@ondev.fr

Marseille, France

Suivez-nous

LinkedInInstagramFacebook
Zones d'intervention
Marseille|Aix-en-Provence|Aubagne|La Ciotat|Cassis|Allauch|Gardanne|Marignane|Vitrolles|Toutes nos zones

© 2026 ONDEV. Tous droits réservés.

Mentions légalesPolitique de confidentialitéPlan du site
ONDEV Logo
Réalisations
Contact
On en discute

Expertise

Création de Sites WebSite Vitrine MarseilleSite E-Commerce MarseilleRéférencement SEOOptimisation GEOApplications Web & MobileAgence CommunicationPublicité en LigneDéveloppeur Web Marseille
Réalisations

Ressources

Qui sommes-nous ?BlogGuides
Contact
AppelerWhatsApp
On en discute
  1. Accueil
  2. Blog
  3. TTFB : réduire le temps de réponse serveur
Développement
24 octobre 202612 mn

TTFB : réduire le temps de réponse serveur

Un TTFB lent pénalise chaque page avant même le premier pixel. Seuils Google, causes et leviers concrets pour un temps de réponse serveur rapide.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

TTFB : réduire le temps de réponse serveur

Sommaire

01.Votre site est déjà lent avant d'avoir affiché le moindre pixel02.TTFB : définition et seuils que Google considère bons03.Les seuils de référence04.Pourquoi le TTFB pèse sur votre SEO05.Ce qui dégrade le temps de réponse serveur06.Un serveur sous-dimensionné ou mutualisé07.Une base de données lente ou lointaine08.Un rendu dynamique à chaque requête09.Le démarrage à froid des fonctions serverless10.Les redirections en chaîne11.Comment mesurer le TTFB12.Dans le navigateur13.Depuis la ligne de commande14.PageSpeed Insights et Lighthouse15.CrUX : la mesure qui compte pour Google16.Améliorer le TTFB : les leviers dans l'ordre d'efficacité17.1. Rendu statique ou ISR18.2. Cache HTTP et CDN19.3. Une région d'hébergement proche de l'audience20.4. La base de données dans la même région que le serveur21.5. Le cas particulier d'une base serverless comme Neon22.6. Supprimer les redirections en chaîne23.Le cas Sudparebrise : Lighthouse 100 avec Next.js, Vercel et Neon24.Les erreurs qui annulent vos efforts25.FAQ : vos questions sur le TTFB26.En résumé : le TTFB se gagne en architecture, pas en bricolage

Votre site est déjà lent avant d'avoir affiché le moindre pixel

Vous avez compressé les images et allégé le JavaScript. Pourtant, la page reste blanche pendant une bonne seconde. Le coupable est côté serveur, dans le délai invisible qui précède le premier octet de réponse : le TTFB. Aucune optimisation front ne peut le rattraper.

Dans cet article, vous allez découvrir :

  • •Ce que mesure le TTFB et le seuil en dessous duquel Google le considère bon
  • •Les 5 causes qui dégradent le temps de réponse serveur, du mutualisé au démarrage à froid
  • •Comment le mesurer sans vous faire piéger par le cache, en laboratoire et sur le terrain
  • •Les leviers classés par efficacité, avec le cas particulier d'une base serverless comme Neon
  • •Comment Sudparebrise obtient un score Lighthouse de 100 avec Next.js, Vercel et Neon
Le LCP d'une page ne peut jamais être plus rapide que son TTFB. Tout ce que vous gagnez côté serveur se répercute directement sur votre score de performance.

TTFB : définition et seuils que Google considère bons

Le TTFB (Time To First Byte) est le temps écoulé entre le moment où le navigateur demande une page et celui où il reçoit le premier octet de la réponse. Il mesure la réactivité du serveur et du réseau, avant tout téléchargement et tout rendu.

Concrètement, il additionne plusieurs étapes successives :

  • •la résolution DNS du nom de domaine ;
  • •l'établissement de la connexion TCP, puis la négociation TLS pour le HTTPS ;
  • •l'envoi de la requête HTTP ;
  • •le traitement côté serveur (exécution du code, requêtes en base, génération du HTML) ;
  • •le transfert du premier octet jusqu'au navigateur.

Sur une infrastructure correcte, les trois premières étapes se jouent en quelques dizaines de millisecondes. C'est le traitement côté serveur qui fait exploser la mesure : c'est là qu'il faut agir en priorité.

Les seuils de référence

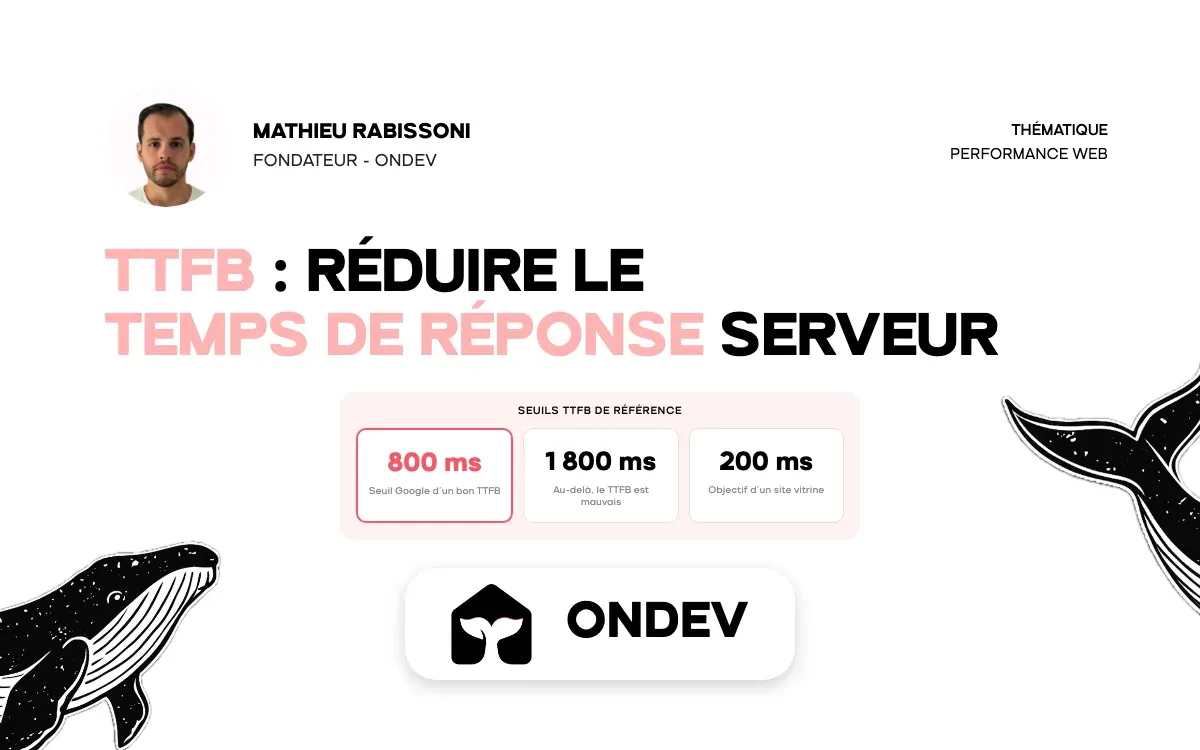
Google publie des seuils clairs pour le TTFB, mesurés au 75e percentile des visites réelles :

TTFB mesuréÉvaluation GoogleCe que ça signifie
Moins de 800 msBonLe serveur ne freine pas le rendu
Entre 800 et 1 800 msÀ améliorerLe LCP sera mécaniquement dégradé
Plus de 1 800 msMauvaisChaque page part avec un handicap de près de 2 secondes
Ces seuils sont documentés dans la fiche TTFB de web.dev, maintenue par l'équipe Chrome. Retenez une chose : 800 ms est un plafond, pas un objectif. Un site vitrine bien architecturé descend sous 200 ms sans difficulté.

Pourquoi le TTFB pèse sur votre SEO

Le TTFB n'est pas un Core Web Vital au sens strict, mais il conditionne directement le LCP (Largest Contentful Paint), qui en est un. Le navigateur ne peut rien peindre tant qu'il n'a pas reçu le HTML : un TTFB de 1,5 seconde garantit un LCP supérieur à 1,5 seconde, quelle que soit la qualité du reste.

Le second effet concerne le crawl. Googlebot ajuste son rythme d'exploration à la réactivité du serveur : un site lent est exploré moins souvent et moins profondément, ce qui freine l'indexation des nouveaux contenus.

Pour voir comment le TTFB s'articule avec le LCP, l'INP et le CLS, notre guide des Core Web Vitals détaille chaque métrique et son poids dans l'évaluation de Google.

Ce qui dégrade le temps de réponse serveur

Cinq situations expliquent la grande majorité des TTFB dégradés que nous rencontrons en audit.

Un serveur sous-dimensionné ou mutualisé

Sur un hébergement mutualisé, votre site partage processeur, mémoire et disque avec des dizaines d'autres. Quand un voisin encaisse un pic de trafic, votre TTFB s'envole sans que vous ayez rien changé. Symptôme typique : un temps de réponse très variable, sans corrélation avec votre propre audience.

Une base de données lente ou lointaine

Chaque requête SQL non indexée, chaque jointure inutile, chaque appel en boucle (le problème N+1) s'additionne dans le TTFB. La distance compte autant que la qualité des requêtes : serveur à Paris et base en Virginie, chaque aller-retour traverse l'Atlantique. Dix requêtes, dix traversées.

Un rendu dynamique à chaque requête

Un CMS classique ou un framework en rendu côté serveur systématique régénère la page à chaque visite : code exécuté, base interrogée, HTML assemblé. Pour une page qui change une fois par semaine, c'est un travail répété des milliers de fois pour rien. C'est la cause la plus fréquente, et la plus facile à corriger.

Le démarrage à froid des fonctions serverless

Une fonction serverless inactive depuis quelques minutes est désallouée. Au prochain appel, la plateforme recharge l'environnement et votre code avant de traiter la requête : c'est le démarrage à froid. Il ajoute de quelques centaines de millisecondes à plus d'une seconde, et frappe précisément le premier visiteur après une période calme, celui qui arrive de Google.

Le même phénomène existe côté base de données : une base serverless qui s'éteint en période d'inactivité doit se réveiller avant la première requête.

Les redirections en chaîne

Chaque redirection impose un aller-retour complet : requête, réponse 301, nouvelle requête. Chaîne classique d'un site mal configuré : http:// vers https://, puis vers www., puis ajout du slash final. Trois redirections avant la page, soit trois TTFB cumulés, que Google comptabilise aussi.

Comment mesurer le TTFB

Une mesure fiable se répète plusieurs fois et croise laboratoire et terrain.

Dans le navigateur

Dans les outils de développement de Chrome, onglet Réseau, cliquez sur la première requête (le document HTML) puis sur l'onglet Timing. La ligne « Waiting for server response » correspond au traitement côté serveur ; DNS, Initial connection et SSL donnent le reste. C'est la méthode la plus précise pour isoler l'étape fautive.

Depuis la ligne de commande

Depuis un terminal, cette commande affiche le temps jusqu'au premier octet :

bash
curl -o /dev/null -s -w "TTFB : %{time_starttransfer}s\n" https://votre-site.fr/

Lancez-la plusieurs fois d'affilée : une première mesure nettement plus lente que les suivantes trahit un démarrage à froid ou un cache vide.

PageSpeed Insights et Lighthouse

PageSpeed Insights signale un TTFB élevé dans l'audit « Réduire le temps de réponse initial du serveur ». C'est une mesure de laboratoire, depuis un centre de données Google : utile pour un diagnostic, insuffisante pour juger l'expérience réelle.

CrUX : la mesure qui compte pour Google

Le Chrome User Experience Report (CrUX) agrège les mesures réelles des utilisateurs de Chrome. C'est cette donnée de terrain qui alimente le rapport Core Web Vitals de la Search Console et le haut de page de PageSpeed Insights : la seule mesure qui reflète ce que Google retient. Un TTFB excellent depuis votre bureau et médiocre dans CrUX signale presque toujours une audience éloignée du serveur ou un démarrage à froid.

À lire aussi : Vitesse de chargement et Core Web Vitals : la méthode pour un site rapide - Le TTFB n'est que la première étape ; cet article couvre tout le chemin jusqu'à la page interactive.

Améliorer le TTFB : les leviers dans l'ordre d'efficacité

Ces leviers sont classés par gain attendu. Commencez par le premier : il règle souvent le problème à lui seul.

1. Rendu statique ou ISR

Le levier le plus puissant consiste à ne plus générer la page à la demande. Avec Next.js, une page statique est construite au déploiement et servie depuis le CDN, au plus près du visiteur. Le serveur applicatif n'est même pas sollicité : le TTFB se réduit au temps réseau.

L'ISR (Incremental Static Regeneration) étend ce principe aux contenus qui changent : la page est servie en cache et régénérée en arrière-plan, à intervalle défini ou quand le CMS publie une modification. Le visiteur reçoit toujours une version déjà construite. C'est notre architecture par défaut pour les sites vitrines et les blogs.

Attention au piège inverse : lire un cookie, un en-tête ou un paramètre d'URL dans le code de la page suffit à la basculer en rendu dynamique. Une seule ligne mal placée peut annuler le bénéfice du statique sur tout le site.

2. Cache HTTP et CDN

Quand le rendu dynamique est inévitable, le cache limite les dégâts. L'en-tête Cache-Control avec une directive s-maxage permet au CDN de conserver la réponse et de la servir sans solliciter le serveur ; stale-while-revalidate va plus loin en servant la version en cache immédiatement et en la rafraîchissant en arrière-plan.

Côté application, un cache en mémoire (Redis ou équivalent) sur les requêtes coûteuses applique une règle simple : tout ce qui est identique pour deux visiteurs successifs ne doit être calculé qu'une fois.

3. Une région d'hébergement proche de l'audience

Un aller-retour réseau entre Paris et la côte est des États-Unis coûte plusieurs dizaines de millisecondes, et aucune optimisation ne changera la physique. Audience française, serveur en Europe. Beaucoup de plateformes cloud déploient par défaut aux États-Unis : vérifiez la région de votre projet, c'est souvent une simple case à cocher.

4. La base de données dans la même région que le serveur

Ce point est trop souvent oublié. Un serveur à Francfort qui interroge une base à Washington subit la latence transatlantique à chaque requête SQL ; une page qui en exécute dix cumule une attente réseau que le visiteur ressent nettement. La base doit être dans la même région que le serveur applicatif, idéalement dans le même centre de données, derrière un pool de connexions qui évite d'en rouvrir une à chaque requête.

5. Le cas particulier d'une base serverless comme Neon

Neon, que nous utilisons sur plusieurs projets, propose la mise à l'échelle à zéro : la base s'éteint après une période d'inactivité et ne coûte rien pendant ce temps. L'avantage est réel en développement. Sur une branche de production exposée au public, c'est un piège pour le TTFB : la première requête après une période calme attend le réveil de la base.

Deux parades, cumulables :

  • •Désactiver l'extinction automatique sur la branche de production. Le surcoût est modeste et le TTFB redevient stable pour tous les visiteurs.
  • •Servir les pages en ISR, de sorte que la base n'est sollicitée qu'à la régénération, jamais pendant la visite. Le réveil de la base devient invisible pour l'utilisateur.

Nous détaillons ce comportement et ses conséquences dans notre comparatif Supabase vs Neon, avec les cas où chaque solution est préférable.

6. Supprimer les redirections en chaîne

Configurez une seule redirection, directement vers l'URL canonique finale : http:// et le domaine sans www doivent pointer en un saut vers https://www.votre-site.fr/. Vérifiez ensuite vos liens internes : un lien vers une URL qui redirige impose ce détour à chaque clic et à chaque passage de Googlebot.

Le cas Sudparebrise : Lighthouse 100 avec Next.js, Vercel et Neon

Pour la refonte du site de Sudparebrise, spécialiste du vitrage automobile, nous avons appliqué exactement cette architecture : un front Next.js servi en statique et en ISR, un CMS Strapi, un hébergement Vercel en région européenne et une base PostgreSQL chez Neon configurée pour la production.

Le résultat se lit dans les outils : un score Lighthouse de 100, un temps de réponse serveur qui se confond avec la latence réseau, et un site en page 1 de Google sur ses requêtes locales. Le TTFB n'est plus un sujet, ce qui a libéré tout l'effort SEO pour le contenu. Le détail est dans notre étude de cas Sudparebrise.

La même logique s'applique aux applications métier, avec une contrainte : les écrans personnalisés par utilisateur ne peuvent pas être servis en statique. Le TTFB se gagne alors sur le cache applicatif, la colocalisation de la base et le découpage des pages, pour que la coquille s'affiche pendant que les données arrivent. C'est le travail d'architecture que nous menons sur chaque application web sur-mesure avant la première ligne de code.

Les erreurs qui annulent vos efforts

  • •Optimiser les images alors que le TTFB dépasse 1,5 seconde. Le gain sera invisible tant que le serveur ne répond pas. Traitez le TTFB en premier.
  • •Mesurer uniquement depuis votre bureau. Vous êtes à côté du serveur, avec un cache chaud. Vos visiteurs ne le sont pas. Fiez-vous à CrUX.
  • •Changer d'hébergeur sans diagnostic. Si la cause est une base lointaine ou un rendu dynamique inutile, un serveur plus puissant ne changera rien.

FAQ : vos questions sur le TTFB

Le TTFB pèse directement sur le LCP mesuré par Google : c'est pourquoi notre référencement naturel à Marseille commence toujours par un audit technique des temps de réponse avant de toucher au contenu.

Qu'est-ce qu'un bon TTFB ?
Google considère qu'un TTFB inférieur à 800 ms est bon, au 75e percentile des visites réelles. Entre 800 et 1 800 ms, il est à améliorer ; au-delà, il est mauvais. Un site vitrine servi en statique depuis un CDN descend couramment sous 200 ms : c'est l'objectif réel, pas le plafond de 800 ms.
Le TTFB est-il un Core Web Vital ?
Non. Les trois Core Web Vitals sont le LCP, l'INP et le CLS. Mais le TTFB est une composante directe du LCP : le navigateur ne peut rien afficher avant le premier octet du HTML. Un mauvais TTFB rend donc un bon LCP impossible, et c'est pour cela que Google le mesure dans PageSpeed Insights et CrUX.
Comment mesurer le TTFB de mon site ?
Trois méthodes complémentaires. Dans Chrome, l'onglet Réseau affiche le détail du premier document, avec la ligne « Waiting for server response ». En ligne de commande, curl avec la variable time_starttransfer donne une mesure brute. Pour la donnée de terrain que Google utilise, consultez le rapport Core Web Vitals de la Search Console, alimenté par CrUX.
Pourquoi mon TTFB est bon dans PageSpeed mais mauvais dans CrUX ?
PageSpeed mesure une seule fois, depuis un centre de données Google, souvent avec un cache déjà chaud. CrUX agrège les visites réelles, y compris la première après une période calme, qui subit le démarrage à froid d'une fonction serverless ou d'une base. C'est le signe d'un problème de cache ou de réveil, pas d'un serveur lent en continu.
Un CDN suffit-il à corriger un TTFB lent ?
Seulement si le CDN peut servir la page depuis son cache. Pour une page statique ou en ISR, oui : le serveur n'est plus sollicité. Pour une page générée à chaque requête, le CDN transmet la demande au serveur d'origine et le TTFB reste celui du serveur, plus un saut réseau. Le CDN amplifie le statique, il ne le remplace pas.

En résumé : le TTFB se gagne en architecture, pas en bricolage

Le temps de réponse serveur est la fondation de toute la performance web : rien ne s'affiche avant lui et le LCP ne peut pas le battre. Les causes sont presque toujours les mêmes (rendu dynamique inutile, base lointaine ou endormie, serveur partagé, redirections en chaîne) et les leviers se classent dans un ordre clair : statique ou ISR d'abord, cache ensuite, colocalisation du serveur et de la base pour finir.

Un site qui passe de 1,5 seconde à 150 ms de TTFB gagne plus d'une seconde sur chaque page avant même de toucher à une image. C'est le chantier le plus rentable d'un audit de performance.


Vous voulez savoir où part le temps de réponse de votre site et combien vous pouvez en récupérer ? Parlons de votre projet : nous posons un diagnostic TTFB précis et nous vous indiquons les leviers à activer en priorité.
Auteur

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

Infos

24 octobre 2026
12 mn
Développement

Service lié

Création site internet

Site sur-mesure avec SEO intégré, livré en 30 jours.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

  • Sans dépendance technique
  • Sans frais de maintenance inutiles
On en discute ?

Avec nous c'est simple, rien n'est compliqué !

Nos réalisations

Refonte & SEO - Amadeus Centre d’Affaires
Refonte & Stratégie SEO

Refonte & SEO - Amadeus Centre d’Affaires

Wiloq - Application SaaS Vestiaire Numérique
Application SaaS

Wiloq - Application SaaS Vestiaire Numérique

Voir toutes les réalisations

Votre site est déjà lent avant d'avoir affiché le moindre pixel

Vous avez compressé les images et allégé le JavaScript. Pourtant, la page reste blanche pendant une bonne seconde. Le coupable est côté serveur, dans le délai invisible qui précède le premier octet de réponse : le TTFB. Aucune optimisation front ne peut le rattraper.

Dans cet article, vous allez découvrir :

  • •Ce que mesure le TTFB et le seuil en dessous duquel Google le considère bon
  • •Les 5 causes qui dégradent le temps de réponse serveur, du mutualisé au démarrage à froid
  • •Comment le mesurer sans vous faire piéger par le cache, en laboratoire et sur le terrain
  • •Les leviers classés par efficacité, avec le cas particulier d'une base serverless comme Neon
  • •Comment Sudparebrise obtient un score Lighthouse de 100 avec Next.js, Vercel et Neon
Le LCP d'une page ne peut jamais être plus rapide que son TTFB. Tout ce que vous gagnez côté serveur se répercute directement sur votre score de performance.

TTFB : définition et seuils que Google considère bons

Le TTFB (Time To First Byte) est le temps écoulé entre le moment où le navigateur demande une page et celui où il reçoit le premier octet de la réponse. Il mesure la réactivité du serveur et du réseau, avant tout téléchargement et tout rendu.

Concrètement, il additionne plusieurs étapes successives :

  • •la résolution DNS du nom de domaine ;
  • •l'établissement de la connexion TCP, puis la négociation TLS pour le HTTPS ;
  • •l'envoi de la requête HTTP ;
  • •le traitement côté serveur (exécution du code, requêtes en base, génération du HTML) ;
  • •le transfert du premier octet jusqu'au navigateur.

Sur une infrastructure correcte, les trois premières étapes se jouent en quelques dizaines de millisecondes. C'est le traitement côté serveur qui fait exploser la mesure : c'est là qu'il faut agir en priorité.

Les seuils de référence

Google publie des seuils clairs pour le TTFB, mesurés au 75e percentile des visites réelles :

TTFB mesuréÉvaluation GoogleCe que ça signifie
Moins de 800 msBonLe serveur ne freine pas le rendu
Entre 800 et 1 800 msÀ améliorerLe LCP sera mécaniquement dégradé
Plus de 1 800 msMauvaisChaque page part avec un handicap de près de 2 secondes
Ces seuils sont documentés dans la fiche TTFB de web.dev, maintenue par l'équipe Chrome. Retenez une chose : 800 ms est un plafond, pas un objectif. Un site vitrine bien architecturé descend sous 200 ms sans difficulté.

Pourquoi le TTFB pèse sur votre SEO

Le TTFB n'est pas un Core Web Vital au sens strict, mais il conditionne directement le LCP (Largest Contentful Paint), qui en est un. Le navigateur ne peut rien peindre tant qu'il n'a pas reçu le HTML : un TTFB de 1,5 seconde garantit un LCP supérieur à 1,5 seconde, quelle que soit la qualité du reste.

Le second effet concerne le crawl. Googlebot ajuste son rythme d'exploration à la réactivité du serveur : un site lent est exploré moins souvent et moins profondément, ce qui freine l'indexation des nouveaux contenus.

Pour voir comment le TTFB s'articule avec le LCP, l'INP et le CLS, notre guide des Core Web Vitals détaille chaque métrique et son poids dans l'évaluation de Google.

Ce qui dégrade le temps de réponse serveur

Cinq situations expliquent la grande majorité des TTFB dégradés que nous rencontrons en audit.

Un serveur sous-dimensionné ou mutualisé

Sur un hébergement mutualisé, votre site partage processeur, mémoire et disque avec des dizaines d'autres. Quand un voisin encaisse un pic de trafic, votre TTFB s'envole sans que vous ayez rien changé. Symptôme typique : un temps de réponse très variable, sans corrélation avec votre propre audience.

Une base de données lente ou lointaine

Chaque requête SQL non indexée, chaque jointure inutile, chaque appel en boucle (le problème N+1) s'additionne dans le TTFB. La distance compte autant que la qualité des requêtes : serveur à Paris et base en Virginie, chaque aller-retour traverse l'Atlantique. Dix requêtes, dix traversées.

Un rendu dynamique à chaque requête

Un CMS classique ou un framework en rendu côté serveur systématique régénère la page à chaque visite : code exécuté, base interrogée, HTML assemblé. Pour une page qui change une fois par semaine, c'est un travail répété des milliers de fois pour rien. C'est la cause la plus fréquente, et la plus facile à corriger.

Le démarrage à froid des fonctions serverless

Une fonction serverless inactive depuis quelques minutes est désallouée. Au prochain appel, la plateforme recharge l'environnement et votre code avant de traiter la requête : c'est le démarrage à froid. Il ajoute de quelques centaines de millisecondes à plus d'une seconde, et frappe précisément le premier visiteur après une période calme, celui qui arrive de Google.

Le même phénomène existe côté base de données : une base serverless qui s'éteint en période d'inactivité doit se réveiller avant la première requête.

Les redirections en chaîne

Chaque redirection impose un aller-retour complet : requête, réponse 301, nouvelle requête. Chaîne classique d'un site mal configuré : http:// vers https://, puis vers www., puis ajout du slash final. Trois redirections avant la page, soit trois TTFB cumulés, que Google comptabilise aussi.

Comment mesurer le TTFB

Une mesure fiable se répète plusieurs fois et croise laboratoire et terrain.

Dans le navigateur

Dans les outils de développement de Chrome, onglet Réseau, cliquez sur la première requête (le document HTML) puis sur l'onglet Timing. La ligne « Waiting for server response » correspond au traitement côté serveur ; DNS, Initial connection et SSL donnent le reste. C'est la méthode la plus précise pour isoler l'étape fautive.

Depuis la ligne de commande

Depuis un terminal, cette commande affiche le temps jusqu'au premier octet :

bash
curl -o /dev/null -s -w "TTFB : %{time_starttransfer}s\n" https://votre-site.fr/

Lancez-la plusieurs fois d'affilée : une première mesure nettement plus lente que les suivantes trahit un démarrage à froid ou un cache vide.

PageSpeed Insights et Lighthouse

PageSpeed Insights signale un TTFB élevé dans l'audit « Réduire le temps de réponse initial du serveur ». C'est une mesure de laboratoire, depuis un centre de données Google : utile pour un diagnostic, insuffisante pour juger l'expérience réelle.

CrUX : la mesure qui compte pour Google

Le Chrome User Experience Report (CrUX) agrège les mesures réelles des utilisateurs de Chrome. C'est cette donnée de terrain qui alimente le rapport Core Web Vitals de la Search Console et le haut de page de PageSpeed Insights : la seule mesure qui reflète ce que Google retient. Un TTFB excellent depuis votre bureau et médiocre dans CrUX signale presque toujours une audience éloignée du serveur ou un démarrage à froid.

À lire aussi : Vitesse de chargement et Core Web Vitals : la méthode pour un site rapide - Le TTFB n'est que la première étape ; cet article couvre tout le chemin jusqu'à la page interactive.

Améliorer le TTFB : les leviers dans l'ordre d'efficacité

Ces leviers sont classés par gain attendu. Commencez par le premier : il règle souvent le problème à lui seul.

1. Rendu statique ou ISR

Le levier le plus puissant consiste à ne plus générer la page à la demande. Avec Next.js, une page statique est construite au déploiement et servie depuis le CDN, au plus près du visiteur. Le serveur applicatif n'est même pas sollicité : le TTFB se réduit au temps réseau.

L'ISR (Incremental Static Regeneration) étend ce principe aux contenus qui changent : la page est servie en cache et régénérée en arrière-plan, à intervalle défini ou quand le CMS publie une modification. Le visiteur reçoit toujours une version déjà construite. C'est notre architecture par défaut pour les sites vitrines et les blogs.

Attention au piège inverse : lire un cookie, un en-tête ou un paramètre d'URL dans le code de la page suffit à la basculer en rendu dynamique. Une seule ligne mal placée peut annuler le bénéfice du statique sur tout le site.

2. Cache HTTP et CDN

Quand le rendu dynamique est inévitable, le cache limite les dégâts. L'en-tête Cache-Control avec une directive s-maxage permet au CDN de conserver la réponse et de la servir sans solliciter le serveur ; stale-while-revalidate va plus loin en servant la version en cache immédiatement et en la rafraîchissant en arrière-plan.

Côté application, un cache en mémoire (Redis ou équivalent) sur les requêtes coûteuses applique une règle simple : tout ce qui est identique pour deux visiteurs successifs ne doit être calculé qu'une fois.

3. Une région d'hébergement proche de l'audience

Un aller-retour réseau entre Paris et la côte est des États-Unis coûte plusieurs dizaines de millisecondes, et aucune optimisation ne changera la physique. Audience française, serveur en Europe. Beaucoup de plateformes cloud déploient par défaut aux États-Unis : vérifiez la région de votre projet, c'est souvent une simple case à cocher.

4. La base de données dans la même région que le serveur

Ce point est trop souvent oublié. Un serveur à Francfort qui interroge une base à Washington subit la latence transatlantique à chaque requête SQL ; une page qui en exécute dix cumule une attente réseau que le visiteur ressent nettement. La base doit être dans la même région que le serveur applicatif, idéalement dans le même centre de données, derrière un pool de connexions qui évite d'en rouvrir une à chaque requête.

5. Le cas particulier d'une base serverless comme Neon

Neon, que nous utilisons sur plusieurs projets, propose la mise à l'échelle à zéro : la base s'éteint après une période d'inactivité et ne coûte rien pendant ce temps. L'avantage est réel en développement. Sur une branche de production exposée au public, c'est un piège pour le TTFB : la première requête après une période calme attend le réveil de la base.

Deux parades, cumulables :

  • •Désactiver l'extinction automatique sur la branche de production. Le surcoût est modeste et le TTFB redevient stable pour tous les visiteurs.
  • •Servir les pages en ISR, de sorte que la base n'est sollicitée qu'à la régénération, jamais pendant la visite. Le réveil de la base devient invisible pour l'utilisateur.

Nous détaillons ce comportement et ses conséquences dans notre comparatif Supabase vs Neon, avec les cas où chaque solution est préférable.

6. Supprimer les redirections en chaîne

Configurez une seule redirection, directement vers l'URL canonique finale : http:// et le domaine sans www doivent pointer en un saut vers https://www.votre-site.fr/. Vérifiez ensuite vos liens internes : un lien vers une URL qui redirige impose ce détour à chaque clic et à chaque passage de Googlebot.

Le cas Sudparebrise : Lighthouse 100 avec Next.js, Vercel et Neon

Pour la refonte du site de Sudparebrise, spécialiste du vitrage automobile, nous avons appliqué exactement cette architecture : un front Next.js servi en statique et en ISR, un CMS Strapi, un hébergement Vercel en région européenne et une base PostgreSQL chez Neon configurée pour la production.

Le résultat se lit dans les outils : un score Lighthouse de 100, un temps de réponse serveur qui se confond avec la latence réseau, et un site en page 1 de Google sur ses requêtes locales. Le TTFB n'est plus un sujet, ce qui a libéré tout l'effort SEO pour le contenu. Le détail est dans notre étude de cas Sudparebrise.

La même logique s'applique aux applications métier, avec une contrainte : les écrans personnalisés par utilisateur ne peuvent pas être servis en statique. Le TTFB se gagne alors sur le cache applicatif, la colocalisation de la base et le découpage des pages, pour que la coquille s'affiche pendant que les données arrivent. C'est le travail d'architecture que nous menons sur chaque application web sur-mesure avant la première ligne de code.

Les erreurs qui annulent vos efforts

  • •Optimiser les images alors que le TTFB dépasse 1,5 seconde. Le gain sera invisible tant que le serveur ne répond pas. Traitez le TTFB en premier.
  • •Mesurer uniquement depuis votre bureau. Vous êtes à côté du serveur, avec un cache chaud. Vos visiteurs ne le sont pas. Fiez-vous à CrUX.
  • •Changer d'hébergeur sans diagnostic. Si la cause est une base lointaine ou un rendu dynamique inutile, un serveur plus puissant ne changera rien.

FAQ : vos questions sur le TTFB

Le TTFB pèse directement sur le LCP mesuré par Google : c'est pourquoi notre référencement naturel à Marseille commence toujours par un audit technique des temps de réponse avant de toucher au contenu.

Qu'est-ce qu'un bon TTFB ?
Google considère qu'un TTFB inférieur à 800 ms est bon, au 75e percentile des visites réelles. Entre 800 et 1 800 ms, il est à améliorer ; au-delà, il est mauvais. Un site vitrine servi en statique depuis un CDN descend couramment sous 200 ms : c'est l'objectif réel, pas le plafond de 800 ms.
Le TTFB est-il un Core Web Vital ?
Non. Les trois Core Web Vitals sont le LCP, l'INP et le CLS. Mais le TTFB est une composante directe du LCP : le navigateur ne peut rien afficher avant le premier octet du HTML. Un mauvais TTFB rend donc un bon LCP impossible, et c'est pour cela que Google le mesure dans PageSpeed Insights et CrUX.
Comment mesurer le TTFB de mon site ?
Trois méthodes complémentaires. Dans Chrome, l'onglet Réseau affiche le détail du premier document, avec la ligne « Waiting for server response ». En ligne de commande, curl avec la variable time_starttransfer donne une mesure brute. Pour la donnée de terrain que Google utilise, consultez le rapport Core Web Vitals de la Search Console, alimenté par CrUX.
Pourquoi mon TTFB est bon dans PageSpeed mais mauvais dans CrUX ?
PageSpeed mesure une seule fois, depuis un centre de données Google, souvent avec un cache déjà chaud. CrUX agrège les visites réelles, y compris la première après une période calme, qui subit le démarrage à froid d'une fonction serverless ou d'une base. C'est le signe d'un problème de cache ou de réveil, pas d'un serveur lent en continu.
Un CDN suffit-il à corriger un TTFB lent ?
Seulement si le CDN peut servir la page depuis son cache. Pour une page statique ou en ISR, oui : le serveur n'est plus sollicité. Pour une page générée à chaque requête, le CDN transmet la demande au serveur d'origine et le TTFB reste celui du serveur, plus un saut réseau. Le CDN amplifie le statique, il ne le remplace pas.

En résumé : le TTFB se gagne en architecture, pas en bricolage

Le temps de réponse serveur est la fondation de toute la performance web : rien ne s'affiche avant lui et le LCP ne peut pas le battre. Les causes sont presque toujours les mêmes (rendu dynamique inutile, base lointaine ou endormie, serveur partagé, redirections en chaîne) et les leviers se classent dans un ordre clair : statique ou ISR d'abord, cache ensuite, colocalisation du serveur et de la base pour finir.

Un site qui passe de 1,5 seconde à 150 ms de TTFB gagne plus d'une seconde sur chaque page avant même de toucher à une image. C'est le chantier le plus rentable d'un audit de performance.


Vous voulez savoir où part le temps de réponse de votre site et combien vous pouvez en récupérer ? Parlons de votre projet : nous posons un diagnostic TTFB précis et nous vous indiquons les leviers à activer en priorité.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

24 octobre 2026
12 mn
Développement

Service lié

Création site internet

Site sur-mesure avec SEO intégré, livré en 30 jours.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

On en discute ?
Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Passionné par le web depuis toujours, j'aide les entreprises à acquérir des clients grâce au digital. Sites web, applications, SEO : je transforme vos idées en solutions performantes.

En savoir plus

Services ONDEV liés à cet article

Création site internet Marseille•Application web sur-mesure•Refonte de site internet•Expert Next.js Marseille•Agence web à Marseille•Nos réalisations

Besoin d'aide pour votre projet ?

Discutons de vos objectifs et voyons comment je peux vous aider à les atteindre.

Prendre rendez-vousAppelerWhatsApp