ONDEV Logo

Expert en acquisition client digitale. Création de sites web et applications sur-mesure qui convertissent.

Services
  • Création de Sites Web
  • Applications Sur-Mesure
  • Publicité Digitale
  • Référencement SEO
  • Développeur Web Marseille
  • Création de Logo
  • Design UX/UI
  • Refonte d'Application
  • Maintenance Applicative
  • Audit de Code
  • Agence Vibe Coding
  • Logiciel Métier Sur-Mesure
  • Agence No Code
  • Portail Client & Extranet
  • Intranet Sur-Mesure
  • Refonte Site WordPress
  • Migration Angular vers React
Navigation
  • Accueil
  • Agence web à Marseille
  • Réalisations
  • Expertise
  • Qui sommes-nous
  • Blog
  • Contact
Guides
  • Nos guides
  • Comment créer un site internet
  • Pourquoi créer un site internet
  • Coût d'un site internet
  • Choisir son prestataire web
Contact

Mathieu Rabissoni

06 01 37 20 21WhatsAppmathieu@ondev.fr

Marseille, France

Suivez-nous

LinkedInInstagramFacebook
Zones d'intervention
Marseille|Aix-en-Provence|Aubagne|La Ciotat|Cassis|Allauch|Gardanne|Marignane|Vitrolles|Toutes nos zones

© 2026 ONDEV. Tous droits réservés.

Mentions légalesPolitique de confidentialitéPlan du site
ONDEV Logo
Réalisations
Contact
On en discute

Expertise

Création de Sites WebSite Vitrine MarseilleSite E-Commerce MarseilleRéférencement SEOOptimisation GEOApplications Web & MobileAgence CommunicationPublicité en LigneDéveloppeur Web Marseille
Réalisations

Ressources

Qui sommes-nous ?BlogGuides
Contact
AppelerWhatsApp
On en discute
  1. Accueil
  2. Blog
  3. JavaScript et SEO : ce que Google voit vraiment
SEO
24 octobre 202612 mn

JavaScript et SEO : ce que Google voit vraiment

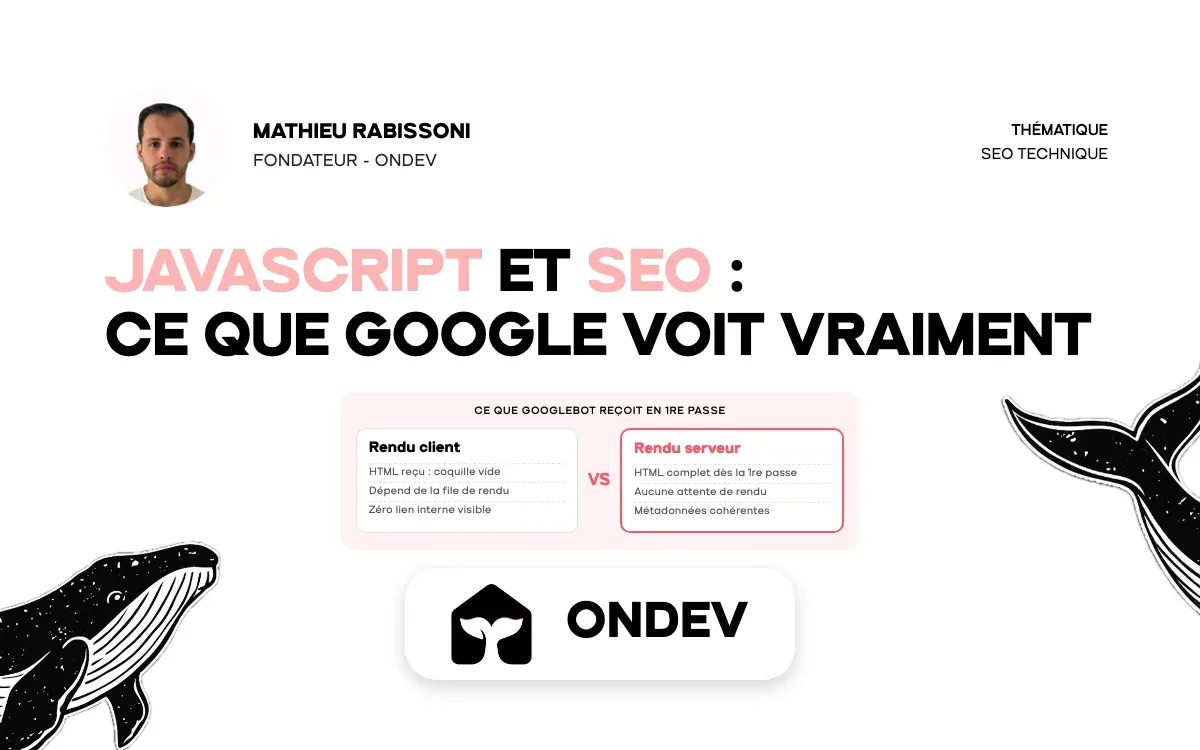
Googlebot lit d'abord votre HTML brut et ne rend le JavaScript que plus tard. Ce qui échappe à cette passe, et comment livrer le HTML complet.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

JavaScript et SEO : ce que Google voit vraiment

Sommaire

01.Votre page est parfaite dans Chrome. Googlebot, lui, n'en voit peut-être que le squelette.02.Comment Googlebot traite le JavaScript : les trois étapes03.Première passe : le HTML brut tel que le serveur l'envoie04.Deuxième passe : la file d'attente de rendu05.Pourquoi le délai est variable06.Ce que Google n'indexe pas, ou indexe tard07.Comment vérifier vous-même ce que Google voit08.Test 1 : l'inspection d'URL dans la Search Console09.Test 2 : le code source contre le DOM10.Test 3 : le crawl comparé11.SPA, rendu serveur, génération statique : trois façons de livrer une page12.La réponse structurelle : Next.js et les Server Components13.Ce que ça change concrètement pour Googlebot14.En production : SNEF et Dassault Aviation15.Les erreurs JavaScript SEO les plus fréquentes16.FAQ : JavaScript et référencement17.Conclusion : livrez à Google du HTML, pas une promesse

Votre page est parfaite dans Chrome. Googlebot, lui, n'en voit peut-être que le squelette.

Un site vitrine refait en React, un blog monté sur un framework JavaScript, une fiche produit qui charge sa description par appel API : dans les trois cas, le navigateur affiche tout. Mais Google lit une page en deux temps, et le second peut arriver bien après le premier. Entre les deux, votre contenu n'existe pas dans l'index.

Le JavaScript SEO n'est pas réservé aux grosses plateformes. C'est la question que devrait se poser toute entreprise dont le site repose sur un framework front-end : qu'est-ce que Google voit vraiment, et à quel moment ?

Dans cet article, vous allez découvrir :

  • •Comment Googlebot traite réellement le JavaScript, étape par étape, et pourquoi le délai de rendu est imprévisible
  • •Les cinq types de contenu qui ne sont pas indexés, ou qui le sont avec plusieurs jours de retard
  • •Trois tests concrets pour vérifier vous-même ce que Google voit sur vos pages, sans outil payant
  • •Pourquoi le rendu serveur et les Server Components de Next.js règlent le problème à la racine, avec deux applications ONDEV en production comme preuve
Google indexe ce qu'il a rendu, pas ce que vous avez codé. Si le contenu n'est pas dans le HTML livré par le serveur, il entre dans une file d'attente dont vous ne contrôlez ni la durée ni la priorité.

Comment Googlebot traite le JavaScript : les trois étapes

Définition : le rendu JavaScript côté Google est le processus par lequel Googlebot exécute le code d'une page dans un navigateur headless (une instance de Chromium sans interface) pour obtenir le HTML final, celui que verrait un visiteur. Cette étape est distincte du crawl et intervient après lui.

Le point à retenir : le crawl et le rendu ne sont pas simultanés. Google le documente dans son guide officiel sur les bases du JavaScript SEO, et le schéma n'a pas changé depuis l'arrivée du Googlebot « evergreen » en 2019, aligné sur les versions récentes de Chrome.

Première passe : le HTML brut tel que le serveur l'envoie

Googlebot demande l'URL, reçoit la réponse HTTP et analyse le HTML tel quel, sans exécuter le moindre script. Il extrait ce qui est déjà présent : titre, balises meta, liens <a href>, texte, données structurées écrites en dur.

Si votre page est une application à page unique (SPA) classique, ce HTML contient souvent une seule <div id="root"></div> et un script. Pour Google, à cet instant, la page est vide : titre générique, zéro lien interne, zéro contenu.

Deuxième passe : la file d'attente de rendu

La page est ensuite placée dans une file d'attente de rendu (render queue). Quand des ressources se libèrent, le Web Rendering Service exécute le JavaScript, attend que le réseau se calme, puis capture le DOM final. C'est ce HTML rendu qui part à l'indexation.

Google explique que ce délai est le plus souvent court. Mais « le plus souvent » n'est pas une garantie : sur un site avec beaucoup d'URL, un budget de crawl limité ou des scripts lourds, il peut s'étaler sur plusieurs jours.

Pourquoi le délai est variable

Trois facteurs jouent sur la durée d'attente :

  • •Le budget de crawl : Google alloue des ressources proportionnelles à l'importance perçue du site. Un nouveau domaine passe derrière les autres.
  • •Le coût du rendu : exécuter du JavaScript coûte bien plus cher que parser du HTML. Bundles lourds et appels API nombreux alourdissent la facture.
  • •Les erreurs et les blocages : un fichier JS bloqué par le robots.txt, une API en erreur, un script qui plante. Le rendu échoue silencieusement et Google indexe ce qu'il a : la coquille vide.

Pour situer cette file dans le parcours complet (découverte, crawl, indexation), notre guide sur le crawling SEO détaille chaque étape et les leviers pour l'accélérer.

Ce que Google n'indexe pas, ou indexe tard

Définition : un contenu dépendant du JavaScript est un contenu absent du HTML initial et qui n'apparaît qu'après exécution d'un script. Il n'est visible pour Google qu'à la deuxième passe, et uniquement si cette passe réussit.

Certains contenus ne sont jamais vus, même après rendu. Voici les cas les plus fréquents en audit.

ÉlémentComportement de GooglebotRisque SEO
Contenu chargé au clic (onglets, accordéons, « voir plus »)Googlebot ne clique pas. Si le contenu n'est pas dans le DOM après le chargement, il n'existe pasTexte invisible, requêtes longue traîne perdues
Scroll infini, « charger plus »Googlebot ne scrolle pas pour déclencher des requêtesProduits ou articles jamais découverts
Liens en onClick ou boutons sans hrefGoogle ne suit que les balises <a> avec un attribut href validePages orphelines, maillage interne inexistant pour Google
Title, canonical ou meta robots modifiés par JSLus à la première passe avec les valeurs du serveur ; la version JS n'est prise en compte qu'au rendu, parfois jamaisMauvaise balise canonique, noindex ignoré ou appliqué à tort
Contenu personnalisé via cookies ou localStorageGooglebot est sans état : il arrive sans cookie, sans sessionPage vide ou version par défaut indexée
Données structurées injectées par un gestionnaire de balisesDépendent du rendu completRich snippets absents ou intermittents
Les métadonnées injectées sont le piège le plus coûteux. Un <title> défini côté serveur à « Mon site » puis remplacé par JavaScript crée deux versions concurrentes, et Google peut indexer la première. Même chose pour une balise canonique posée par un script : si elle contredit celle du HTML brut, le résultat est imprévisible.

Les liens non HTML cassent le maillage. Un menu construit en <div onClick> est parfaitement cliquable pour un humain et invisible pour Google. Vos pages profondes ne reçoivent aucun lien, donc aucune autorité. Notre article sur l'indexation Google et le référencement explique comment repérer les pages découvertes mais jamais indexées.

Comment vérifier vous-même ce que Google voit

Pas besoin d'outil payant pour mesurer l'écart entre ce que vous codez et ce que Google indexe. Trois tests suffisent.

Test 1 : l'inspection d'URL dans la Search Console

C'est la source la plus fiable, puisque c'est Google qui rend la page.

  1. 1.Ouvrez la Search Console, collez l'URL dans la barre d'inspection.
  2. 2.Cliquez sur Tester l'URL en direct : Google crawle et rend la page à l'instant.
  3. 3.Ouvrez Afficher la page testée : l'onglet HTML montre le DOM rendu (celui qui compte), Capture d'écran ce que Googlebot a vu, Plus d'infos les ressources bloquées et les erreurs JavaScript.

Cherchez dans l'onglet HTML un extrait de texte que vous savez chargé par JavaScript. S'il y est, le rendu fonctionne. S'il manque, vous avez trouvé votre problème. La liste des ressources non chargées révèle aussi une API bloquée ou en timeout.

Test 2 : le code source contre le DOM

Affichez le code source de la page (Ctrl+U ou Cmd+Option+U) : c'est exactement ce que Googlebot reçoit à la première passe. Comparez-le avec l'inspecteur d'éléments, qui montre le DOM après exécution des scripts.

Si le code source contient votre H1, vos paragraphes et vos liens, vous êtes rendu côté serveur. S'il ne contient qu'une div vide et des balises <script>, tout votre contenu dépend de la deuxième passe. Variante rapide : désactivez le JavaScript dans le navigateur et rechargez. Ce que vous voyez est, au mieux, ce que Google indexe immédiatement.

Test 3 : le crawl comparé

Pour un site entier, lancez un crawler en mode HTML seul puis avec rendu JavaScript, et comparez liens internes, titres et volume de texte. Symptôme typique d'une SPA : le crawl HTML ne trouve que la page d'accueil.

SPA, rendu serveur, génération statique : trois façons de livrer une page

Définition : une SPA (Single Page Application) est une application web dont le serveur envoie une page HTML quasi vide, le contenu étant ensuite construit entièrement dans le navigateur par JavaScript. À l'opposé, le rendu serveur (SSR) et la génération statique (SSG) produisent le HTML complet avant qu'il n'atteigne le navigateur.

Le choix de la stratégie de rendu détermine directement ce que Googlebot reçoit à la première passe.

StratégieHTML reçu à la première passeDépendance à la file de renduUsage recommandé
Rendu client (CSR, SPA pure)Coquille vide, scriptsTotaleInterfaces connectées, back-offices, zones privées
Rendu serveur (SSR)HTML complet, généré à chaque requêteNulle pour le contenu principalPages dynamiques, résultats de recherche, catalogues
Génération statique (SSG)HTML complet, généré au buildNulleSites vitrines, blogs, pages de service
Le rendu client a sa place : un tableau de bord derrière un login n'a aucune raison d'être indexé. Le problème commence quand un site public est construit avec la même approche.

Notre position est ferme : un site vitrine ou un blog ne devrait jamais dépendre du rendu JavaScript côté client pour son contenu principal. Le texte, les titres, les liens, les métadonnées et les données structurées doivent être présents dans la réponse HTTP. Le JavaScript sert à enrichir l'expérience, pas à la créer.

À lire aussi : Next.js : pourquoi c'est le meilleur framework pour votre site en 2026 : sept raisons techniques et SEO de choisir ce framework pour un site public.

La réponse structurelle : Next.js et les Server Components

Définition : les React Server Components sont des composants exécutés uniquement sur le serveur. Leur rendu produit du HTML qui est envoyé au navigateur sans que leur code JavaScript ne soit jamais téléchargé par le client.

C'est un changement de nature par rapport au SSR classique, où le serveur génère le HTML puis le navigateur télécharge tout le JavaScript pour « réhydrater » la page : le contenu est présent dès la première passe, mais le poids des scripts reste élevé.

Avec l'App Router de Next.js, chaque composant est un Server Component par défaut. Page d'article, fiche service, liste de réalisations : tout est rendu côté serveur, et seuls les composants marqués comme interactifs (un formulaire, un carrousel) embarquent du JavaScript côté client.

Ce que ça change concrètement pour Googlebot

  • •Le HTML brut contient tout : H1, paragraphes, liens <a href>, balises meta, JSON-LD. La première passe suffit à indexer la page entière.
  • •La file de rendu devient un bonus, pas une dépendance. Si Google rend la page, il retrouve la même chose. S'il ne la rend pas, rien n'est perdu.
  • •Les métadonnées sont cohérentes : l'API generateMetadata produit title, description et canonical côté serveur. Une seule version, celle que Google lit en premier.
  • •Les bundles sont plus légers, ce qui réduit le coût de rendu et améliore les Core Web Vitals.

Pour une équipe déjà familière de React, la migration ne demande pas de changer de langage ni de paradigme. C'est ce que nous accompagnons en tant qu'agence React spécialisée : garder l'écosystème React tout en livrant à Google un HTML complet dès la première requête.

En production : SNEF et Dassault Aviation

Le rendu serveur n'est pas réservé aux sites vitrines légers. Deux applications métier que nous avons développées tournent en production avec cette architecture.

Pour SNEF, nous avons construit une application de visualisation de schémas électriques en Next.js, TypeScript et PostgreSQL. Le rendu côté serveur livre les vues techniques complètes dès la première réponse, et les équipes gagnent 1h30 tous les deux jours. Un contenu dense, structuré, servi en HTML : exactement ce qu'un moteur sait lire.

Pour Dassault Aviation, l'application métier compte plus de 90 utilisateurs actifs. Là encore, le rendu serveur garantit que chaque écran arrive complet, sans attendre qu'un bundle s'exécute dans le navigateur.

Si des applications de cette complexité tournent en rendu serveur, un site vitrine de dix pages n'a aucune excuse pour envoyer une div vide à Google.

Les erreurs JavaScript SEO les plus fréquentes

Même avec un framework moderne, certaines pratiques réintroduisent le problème. Voici celles que nous corrigeons le plus souvent.

  1. 1.Le composant client qui englobe la page. Un 'use client' posé trop haut dans l'arbre transforme toute la page en rendu client. Vérifiez que la directive n'apparaît que sur les composants réellement interactifs.
  2. 2.Les données chargées dans un useEffect. Le contenu principal récupéré après le montage du composant n'est pas dans le HTML initial. Remontez l'appel dans un Server Component ou dans la fonction de chargement de la page.
  3. 3.Le menu en boutons. Des éléments de navigation en <button onClick> au lieu de <a href>. Le composant Link de Next.js génère un vrai lien HTML : utilisez-le.
  4. 4.Les ressources bloquées par robots.txt. Un dossier /_next/ interdit au crawl empêche Google d'exécuter vos scripts.
  5. 5.Le contenu injecté au clic. Rendez tous les panneaux d'onglets dans le DOM et masquez-les en CSS : Google indexe le contenu caché visuellement, pas le contenu absent.

FAQ : JavaScript et référencement

Vérifier ce que Googlebot voit réellement de vos pages fait partie de l'audit technique de notre service de référencement naturel : rendu, ressources bloquées et contenu absent du HTML initial.

Google peut-il indexer un site en JavaScript ?
Oui. Googlebot exécute le JavaScript avec une version récente de Chromium et indexe le HTML rendu. Mais ce rendu intervient dans une seconde passe, après le crawl, avec un délai variable. Un site dont le contenu dépend entièrement du JavaScript est indexé plus lentement, moins fiablement, et perd tout ce qui échoue au rendu.
Combien de temps Google met-il à rendre une page JavaScript ?
Google indique que le délai est généralement court. En pratique, il dépend du budget de crawl alloué au site, de la lourdeur des scripts et de la charge des serveurs de rendu. Sur un site récent ou volumineux, il peut atteindre plusieurs jours. Surtout, il n'est pas garanti : vous ne pouvez ni le mesurer précisément ni le forcer.
Une SPA React est-elle mauvaise pour le SEO ?
Une SPA en rendu client pur est pénalisante pour un site public : la première passe de Google reçoit une page vide, le maillage interne n'existe pas sans JavaScript et les métadonnées sont souvent incohérentes. React en soi n'est pas le problème. Avec Next.js et les Server Components, le même code React produit un HTML complet côté serveur, et le SEO redevient un non-sujet.
Comment savoir si mon site dépend du rendu JavaScript ?
Affichez le code source de la page (pas l'inspecteur). Si vous y trouvez votre titre, vos paragraphes et vos liens, le contenu est rendu côté serveur. Si vous ne voyez qu'une div vide et des balises script, votre site dépend du rendu client. Confirmez ensuite avec l'outil d'inspection d'URL de la Search Console, onglet HTML de la page testée.
Le pré-rendu ou le rendu dynamique sont-ils une bonne solution ?
Ce sont des contournements. Le rendu dynamique, qui sert une version HTML aux robots et une version JavaScript aux humains, est considéré par Google comme une solution de transition, pas une architecture cible. Il ajoute une infrastructure à maintenir et un risque d'écart entre les versions. Le rendu serveur natif avec Next.js supprime le problème au lieu de le masquer.

Conclusion : livrez à Google du HTML, pas une promesse

Googlebot lit vos pages en deux temps. La première passe ne voit que le HTML du serveur ; la seconde, celle qui exécute le JavaScript, arrive avec un délai que vous ne maîtrisez pas et échoue parfois sans prévenir. Tout contenu qui dépend de cette seconde passe a une indexation incertaine.

La réponse n'est pas d'abandonner React. C'est de choisir une architecture qui produit le HTML complet côté serveur : SSR, génération statique, Server Components. Next.js le fait par défaut, et nous le faisons tourner en production sur des applications bien plus complexes qu'un site vitrine.

Le test du code source prend trente secondes. Si le résultat vous inquiète, la suite se discute.


Votre site repose sur du JavaScript et vous voulez savoir ce que Google en indexe réellement ? Demandez un devis pour un audit de rendu et une migration vers Next.js : nous analysons vos pages, chiffrons l'écart et proposons une architecture qui livre tout dès la première passe.
Auteur

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

Infos

24 octobre 2026
12 mn
SEO

Service lié

Référencement SEO

1ère page Google pour vos mots-clés à Marseille.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

  • Sans dépendance technique
  • Sans frais de maintenance inutiles
On en discute ?

Avec nous c'est simple, rien n'est compliqué !

Nos réalisations

Refonte & SEO - Amadeus Centre d’Affaires
Refonte & Stratégie SEO

Refonte & SEO - Amadeus Centre d’Affaires

Wiloq - Application SaaS Vestiaire Numérique
Application SaaS

Wiloq - Application SaaS Vestiaire Numérique

Voir toutes les réalisations

Votre page est parfaite dans Chrome. Googlebot, lui, n'en voit peut-être que le squelette.

Un site vitrine refait en React, un blog monté sur un framework JavaScript, une fiche produit qui charge sa description par appel API : dans les trois cas, le navigateur affiche tout. Mais Google lit une page en deux temps, et le second peut arriver bien après le premier. Entre les deux, votre contenu n'existe pas dans l'index.

Le JavaScript SEO n'est pas réservé aux grosses plateformes. C'est la question que devrait se poser toute entreprise dont le site repose sur un framework front-end : qu'est-ce que Google voit vraiment, et à quel moment ?

Dans cet article, vous allez découvrir :

  • •Comment Googlebot traite réellement le JavaScript, étape par étape, et pourquoi le délai de rendu est imprévisible
  • •Les cinq types de contenu qui ne sont pas indexés, ou qui le sont avec plusieurs jours de retard
  • •Trois tests concrets pour vérifier vous-même ce que Google voit sur vos pages, sans outil payant
  • •Pourquoi le rendu serveur et les Server Components de Next.js règlent le problème à la racine, avec deux applications ONDEV en production comme preuve
Google indexe ce qu'il a rendu, pas ce que vous avez codé. Si le contenu n'est pas dans le HTML livré par le serveur, il entre dans une file d'attente dont vous ne contrôlez ni la durée ni la priorité.

Comment Googlebot traite le JavaScript : les trois étapes

Définition : le rendu JavaScript côté Google est le processus par lequel Googlebot exécute le code d'une page dans un navigateur headless (une instance de Chromium sans interface) pour obtenir le HTML final, celui que verrait un visiteur. Cette étape est distincte du crawl et intervient après lui.

Le point à retenir : le crawl et le rendu ne sont pas simultanés. Google le documente dans son guide officiel sur les bases du JavaScript SEO, et le schéma n'a pas changé depuis l'arrivée du Googlebot « evergreen » en 2019, aligné sur les versions récentes de Chrome.

Première passe : le HTML brut tel que le serveur l'envoie

Googlebot demande l'URL, reçoit la réponse HTTP et analyse le HTML tel quel, sans exécuter le moindre script. Il extrait ce qui est déjà présent : titre, balises meta, liens <a href>, texte, données structurées écrites en dur.

Si votre page est une application à page unique (SPA) classique, ce HTML contient souvent une seule <div id="root"></div> et un script. Pour Google, à cet instant, la page est vide : titre générique, zéro lien interne, zéro contenu.

Deuxième passe : la file d'attente de rendu

La page est ensuite placée dans une file d'attente de rendu (render queue). Quand des ressources se libèrent, le Web Rendering Service exécute le JavaScript, attend que le réseau se calme, puis capture le DOM final. C'est ce HTML rendu qui part à l'indexation.

Google explique que ce délai est le plus souvent court. Mais « le plus souvent » n'est pas une garantie : sur un site avec beaucoup d'URL, un budget de crawl limité ou des scripts lourds, il peut s'étaler sur plusieurs jours.

Pourquoi le délai est variable

Trois facteurs jouent sur la durée d'attente :

  • •Le budget de crawl : Google alloue des ressources proportionnelles à l'importance perçue du site. Un nouveau domaine passe derrière les autres.
  • •Le coût du rendu : exécuter du JavaScript coûte bien plus cher que parser du HTML. Bundles lourds et appels API nombreux alourdissent la facture.
  • •Les erreurs et les blocages : un fichier JS bloqué par le robots.txt, une API en erreur, un script qui plante. Le rendu échoue silencieusement et Google indexe ce qu'il a : la coquille vide.

Pour situer cette file dans le parcours complet (découverte, crawl, indexation), notre guide sur le crawling SEO détaille chaque étape et les leviers pour l'accélérer.

Ce que Google n'indexe pas, ou indexe tard

Définition : un contenu dépendant du JavaScript est un contenu absent du HTML initial et qui n'apparaît qu'après exécution d'un script. Il n'est visible pour Google qu'à la deuxième passe, et uniquement si cette passe réussit.

Certains contenus ne sont jamais vus, même après rendu. Voici les cas les plus fréquents en audit.

ÉlémentComportement de GooglebotRisque SEO
Contenu chargé au clic (onglets, accordéons, « voir plus »)Googlebot ne clique pas. Si le contenu n'est pas dans le DOM après le chargement, il n'existe pasTexte invisible, requêtes longue traîne perdues
Scroll infini, « charger plus »Googlebot ne scrolle pas pour déclencher des requêtesProduits ou articles jamais découverts
Liens en onClick ou boutons sans hrefGoogle ne suit que les balises <a> avec un attribut href validePages orphelines, maillage interne inexistant pour Google
Title, canonical ou meta robots modifiés par JSLus à la première passe avec les valeurs du serveur ; la version JS n'est prise en compte qu'au rendu, parfois jamaisMauvaise balise canonique, noindex ignoré ou appliqué à tort
Contenu personnalisé via cookies ou localStorageGooglebot est sans état : il arrive sans cookie, sans sessionPage vide ou version par défaut indexée
Données structurées injectées par un gestionnaire de balisesDépendent du rendu completRich snippets absents ou intermittents
Les métadonnées injectées sont le piège le plus coûteux. Un <title> défini côté serveur à « Mon site » puis remplacé par JavaScript crée deux versions concurrentes, et Google peut indexer la première. Même chose pour une balise canonique posée par un script : si elle contredit celle du HTML brut, le résultat est imprévisible.

Les liens non HTML cassent le maillage. Un menu construit en <div onClick> est parfaitement cliquable pour un humain et invisible pour Google. Vos pages profondes ne reçoivent aucun lien, donc aucune autorité. Notre article sur l'indexation Google et le référencement explique comment repérer les pages découvertes mais jamais indexées.

Comment vérifier vous-même ce que Google voit

Pas besoin d'outil payant pour mesurer l'écart entre ce que vous codez et ce que Google indexe. Trois tests suffisent.

Test 1 : l'inspection d'URL dans la Search Console

C'est la source la plus fiable, puisque c'est Google qui rend la page.

  1. 1.Ouvrez la Search Console, collez l'URL dans la barre d'inspection.
  2. 2.Cliquez sur Tester l'URL en direct : Google crawle et rend la page à l'instant.
  3. 3.Ouvrez Afficher la page testée : l'onglet HTML montre le DOM rendu (celui qui compte), Capture d'écran ce que Googlebot a vu, Plus d'infos les ressources bloquées et les erreurs JavaScript.

Cherchez dans l'onglet HTML un extrait de texte que vous savez chargé par JavaScript. S'il y est, le rendu fonctionne. S'il manque, vous avez trouvé votre problème. La liste des ressources non chargées révèle aussi une API bloquée ou en timeout.

Test 2 : le code source contre le DOM

Affichez le code source de la page (Ctrl+U ou Cmd+Option+U) : c'est exactement ce que Googlebot reçoit à la première passe. Comparez-le avec l'inspecteur d'éléments, qui montre le DOM après exécution des scripts.

Si le code source contient votre H1, vos paragraphes et vos liens, vous êtes rendu côté serveur. S'il ne contient qu'une div vide et des balises <script>, tout votre contenu dépend de la deuxième passe. Variante rapide : désactivez le JavaScript dans le navigateur et rechargez. Ce que vous voyez est, au mieux, ce que Google indexe immédiatement.

Test 3 : le crawl comparé

Pour un site entier, lancez un crawler en mode HTML seul puis avec rendu JavaScript, et comparez liens internes, titres et volume de texte. Symptôme typique d'une SPA : le crawl HTML ne trouve que la page d'accueil.

SPA, rendu serveur, génération statique : trois façons de livrer une page

Définition : une SPA (Single Page Application) est une application web dont le serveur envoie une page HTML quasi vide, le contenu étant ensuite construit entièrement dans le navigateur par JavaScript. À l'opposé, le rendu serveur (SSR) et la génération statique (SSG) produisent le HTML complet avant qu'il n'atteigne le navigateur.

Le choix de la stratégie de rendu détermine directement ce que Googlebot reçoit à la première passe.

StratégieHTML reçu à la première passeDépendance à la file de renduUsage recommandé
Rendu client (CSR, SPA pure)Coquille vide, scriptsTotaleInterfaces connectées, back-offices, zones privées
Rendu serveur (SSR)HTML complet, généré à chaque requêteNulle pour le contenu principalPages dynamiques, résultats de recherche, catalogues
Génération statique (SSG)HTML complet, généré au buildNulleSites vitrines, blogs, pages de service
Le rendu client a sa place : un tableau de bord derrière un login n'a aucune raison d'être indexé. Le problème commence quand un site public est construit avec la même approche.

Notre position est ferme : un site vitrine ou un blog ne devrait jamais dépendre du rendu JavaScript côté client pour son contenu principal. Le texte, les titres, les liens, les métadonnées et les données structurées doivent être présents dans la réponse HTTP. Le JavaScript sert à enrichir l'expérience, pas à la créer.

À lire aussi : Next.js : pourquoi c'est le meilleur framework pour votre site en 2026 : sept raisons techniques et SEO de choisir ce framework pour un site public.

La réponse structurelle : Next.js et les Server Components

Définition : les React Server Components sont des composants exécutés uniquement sur le serveur. Leur rendu produit du HTML qui est envoyé au navigateur sans que leur code JavaScript ne soit jamais téléchargé par le client.

C'est un changement de nature par rapport au SSR classique, où le serveur génère le HTML puis le navigateur télécharge tout le JavaScript pour « réhydrater » la page : le contenu est présent dès la première passe, mais le poids des scripts reste élevé.

Avec l'App Router de Next.js, chaque composant est un Server Component par défaut. Page d'article, fiche service, liste de réalisations : tout est rendu côté serveur, et seuls les composants marqués comme interactifs (un formulaire, un carrousel) embarquent du JavaScript côté client.

Ce que ça change concrètement pour Googlebot

  • •Le HTML brut contient tout : H1, paragraphes, liens <a href>, balises meta, JSON-LD. La première passe suffit à indexer la page entière.
  • •La file de rendu devient un bonus, pas une dépendance. Si Google rend la page, il retrouve la même chose. S'il ne la rend pas, rien n'est perdu.
  • •Les métadonnées sont cohérentes : l'API generateMetadata produit title, description et canonical côté serveur. Une seule version, celle que Google lit en premier.
  • •Les bundles sont plus légers, ce qui réduit le coût de rendu et améliore les Core Web Vitals.

Pour une équipe déjà familière de React, la migration ne demande pas de changer de langage ni de paradigme. C'est ce que nous accompagnons en tant qu'agence React spécialisée : garder l'écosystème React tout en livrant à Google un HTML complet dès la première requête.

En production : SNEF et Dassault Aviation

Le rendu serveur n'est pas réservé aux sites vitrines légers. Deux applications métier que nous avons développées tournent en production avec cette architecture.

Pour SNEF, nous avons construit une application de visualisation de schémas électriques en Next.js, TypeScript et PostgreSQL. Le rendu côté serveur livre les vues techniques complètes dès la première réponse, et les équipes gagnent 1h30 tous les deux jours. Un contenu dense, structuré, servi en HTML : exactement ce qu'un moteur sait lire.

Pour Dassault Aviation, l'application métier compte plus de 90 utilisateurs actifs. Là encore, le rendu serveur garantit que chaque écran arrive complet, sans attendre qu'un bundle s'exécute dans le navigateur.

Si des applications de cette complexité tournent en rendu serveur, un site vitrine de dix pages n'a aucune excuse pour envoyer une div vide à Google.

Les erreurs JavaScript SEO les plus fréquentes

Même avec un framework moderne, certaines pratiques réintroduisent le problème. Voici celles que nous corrigeons le plus souvent.

  1. 1.Le composant client qui englobe la page. Un 'use client' posé trop haut dans l'arbre transforme toute la page en rendu client. Vérifiez que la directive n'apparaît que sur les composants réellement interactifs.
  2. 2.Les données chargées dans un useEffect. Le contenu principal récupéré après le montage du composant n'est pas dans le HTML initial. Remontez l'appel dans un Server Component ou dans la fonction de chargement de la page.
  3. 3.Le menu en boutons. Des éléments de navigation en <button onClick> au lieu de <a href>. Le composant Link de Next.js génère un vrai lien HTML : utilisez-le.
  4. 4.Les ressources bloquées par robots.txt. Un dossier /_next/ interdit au crawl empêche Google d'exécuter vos scripts.
  5. 5.Le contenu injecté au clic. Rendez tous les panneaux d'onglets dans le DOM et masquez-les en CSS : Google indexe le contenu caché visuellement, pas le contenu absent.

FAQ : JavaScript et référencement

Vérifier ce que Googlebot voit réellement de vos pages fait partie de l'audit technique de notre service de référencement naturel : rendu, ressources bloquées et contenu absent du HTML initial.

Google peut-il indexer un site en JavaScript ?
Oui. Googlebot exécute le JavaScript avec une version récente de Chromium et indexe le HTML rendu. Mais ce rendu intervient dans une seconde passe, après le crawl, avec un délai variable. Un site dont le contenu dépend entièrement du JavaScript est indexé plus lentement, moins fiablement, et perd tout ce qui échoue au rendu.
Combien de temps Google met-il à rendre une page JavaScript ?
Google indique que le délai est généralement court. En pratique, il dépend du budget de crawl alloué au site, de la lourdeur des scripts et de la charge des serveurs de rendu. Sur un site récent ou volumineux, il peut atteindre plusieurs jours. Surtout, il n'est pas garanti : vous ne pouvez ni le mesurer précisément ni le forcer.
Une SPA React est-elle mauvaise pour le SEO ?
Une SPA en rendu client pur est pénalisante pour un site public : la première passe de Google reçoit une page vide, le maillage interne n'existe pas sans JavaScript et les métadonnées sont souvent incohérentes. React en soi n'est pas le problème. Avec Next.js et les Server Components, le même code React produit un HTML complet côté serveur, et le SEO redevient un non-sujet.
Comment savoir si mon site dépend du rendu JavaScript ?
Affichez le code source de la page (pas l'inspecteur). Si vous y trouvez votre titre, vos paragraphes et vos liens, le contenu est rendu côté serveur. Si vous ne voyez qu'une div vide et des balises script, votre site dépend du rendu client. Confirmez ensuite avec l'outil d'inspection d'URL de la Search Console, onglet HTML de la page testée.
Le pré-rendu ou le rendu dynamique sont-ils une bonne solution ?
Ce sont des contournements. Le rendu dynamique, qui sert une version HTML aux robots et une version JavaScript aux humains, est considéré par Google comme une solution de transition, pas une architecture cible. Il ajoute une infrastructure à maintenir et un risque d'écart entre les versions. Le rendu serveur natif avec Next.js supprime le problème au lieu de le masquer.

Conclusion : livrez à Google du HTML, pas une promesse

Googlebot lit vos pages en deux temps. La première passe ne voit que le HTML du serveur ; la seconde, celle qui exécute le JavaScript, arrive avec un délai que vous ne maîtrisez pas et échoue parfois sans prévenir. Tout contenu qui dépend de cette seconde passe a une indexation incertaine.

La réponse n'est pas d'abandonner React. C'est de choisir une architecture qui produit le HTML complet côté serveur : SSR, génération statique, Server Components. Next.js le fait par défaut, et nous le faisons tourner en production sur des applications bien plus complexes qu'un site vitrine.

Le test du code source prend trente secondes. Si le résultat vous inquiète, la suite se discute.


Votre site repose sur du JavaScript et vous voulez savoir ce que Google en indexe réellement ? Demandez un devis pour un audit de rendu et une migration vers Next.js : nous analysons vos pages, chiffrons l'écart et proposons une architecture qui livre tout dès la première passe.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

24 octobre 2026
12 mn
SEO

Service lié

Référencement SEO

1ère page Google pour vos mots-clés à Marseille.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

On en discute ?
Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Passionné par le web depuis toujours, j'aide les entreprises à acquérir des clients grâce au digital. Sites web, applications, SEO : je transforme vos idées en solutions performantes.

En savoir plus

Services ONDEV liés à cet article

Référencement SEO Marseille•Consultant SEO Marseille•Optimisation GEO & IA•Site internet optimisé SEO•Guide Google My Business•Nos réalisations

Besoin d'aide pour votre projet ?

Discutons de vos objectifs et voyons comment je peux vous aider à les atteindre.

Prendre rendez-vousAppelerWhatsApp