ONDEV Logo

Expert en acquisition client digitale. Création de sites web et applications sur-mesure qui convertissent.

Services
  • Création de Sites Web
  • Applications Sur-Mesure
  • Publicité Digitale
  • Référencement SEO
  • Développeur Web Marseille
  • Création de Logo
  • Design UX/UI
  • Refonte d'Application
  • Maintenance Applicative
  • Audit de Code
  • Agence Vibe Coding
  • Logiciel Métier Sur-Mesure
  • Agence No Code
  • Portail Client & Extranet
  • Intranet Sur-Mesure
  • Refonte Site WordPress
  • Migration Angular vers React
Navigation
  • Accueil
  • Agence web à Marseille
  • Réalisations
  • Expertise
  • Qui sommes-nous
  • Blog
  • Contact
Guides
  • Nos guides
  • Comment créer un site internet
  • Pourquoi créer un site internet
  • Coût d'un site internet
  • Choisir son prestataire web
Contact

Mathieu Rabissoni

06 01 37 20 21WhatsAppmathieu@ondev.fr

Marseille, France

Suivez-nous

LinkedInInstagramFacebook
Zones d'intervention
Marseille|Aix-en-Provence|Aubagne|La Ciotat|Cassis|Allauch|Gardanne|Marignane|Vitrolles|Toutes nos zones

© 2026 ONDEV. Tous droits réservés.

Mentions légalesPolitique de confidentialitéPlan du site
ONDEV Logo
Réalisations
Contact
On en discute

Expertise

Création de Sites WebSite Vitrine MarseilleSite E-Commerce MarseilleRéférencement SEOOptimisation GEOApplications Web & MobileAgence CommunicationPublicité en LigneDéveloppeur Web Marseille
Réalisations

Ressources

Qui sommes-nous ?BlogGuides
Contact
AppelerWhatsApp
On en discute
  1. Accueil
  2. Blog
  3. Balise noindex : quand et comment l'utiliser
SEO
24 octobre 202612 mn

Balise noindex : quand et comment l'utiliser

Noindex, robots.txt, canonical, 410 : quatre outils confondus en permanence. Arbre de décision, cas d'usage légitimes et erreurs qui désindexent tout.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Balise noindex : quand et comment l'utiliser

Sommaire

01.Une seule ligne de code suffit à faire disparaître votre site de Google02.Qu'est-ce que la balise noindex ? Définition nette03.Deux façons de la déclarer : meta robots et X-Robots-Tag04.noindex, nofollow, noindex nofollow : trois consignes différentes05.Noindex, robots.txt, canonical, 410 : quatre outils, quatre problèmes06.Pourquoi bloquer dans robots.txt empêche Google de voir le noindex07.L'arbre de décision : quel outil pour quel cas08.Les cas d'usage légitimes de la balise noindex09.Les pages de remerciement et de confirmation10.Les pages de capture et landing pages dédiées11.Les filtres, tris et facettes12.Les environnements de test et de préproduction13.Les erreurs qui désindexent un site entier14.Comment vérifier que Google a pris le noindex en compte15.Vérifier que la directive est bien servie16.Vérifier que Google l'a lue17.FAQ : vos questions sur la balise noindex18.Ce qu'il faut retenir avant de toucher à une balise

Une seule ligne de code suffit à faire disparaître votre site de Google

La balise noindex est l'un des outils les plus puissants du SEO technique, et l'un des plus mal utilisés. Posée au bon endroit, elle concentre la visibilité sur les pages qui comptent. Oubliée après une mise en production, elle efface des mois de travail en quelques jours de crawl, sans que personne ne s'en aperçoive avant la chute du trafic.

Dans cet article, vous allez découvrir :

  • •Ce que fait exactement la balise noindex, et ce qu'elle ne fait pas (la confusion avec nofollow coûte cher)
  • •Pourquoi noindex, robots.txt, canonical et 410 répondent à quatre problèmes différents, avec un arbre de décision pour choisir sans hésiter
  • •Les cas d'usage légitimes, dont la pratique ONDEV sur les pages de capture
  • •Les erreurs qui désindexent un site entier, et pourquoi bloquer une page dans robots.txt empêche Google de voir votre noindex
  • •La méthode pour vérifier que Google a bien pris la consigne en compte
Désindexer n'est pas supprimer. Quatre outils, quatre intentions : si vous ne savez pas lequel choisir, vous n'avez pas encore identifié le problème.

Qu'est-ce que la balise noindex ? Définition nette

La balise noindex est une directive adressée aux moteurs de recherche qui leur demande de ne pas afficher une page dans leurs résultats, tout en les laissant libres de la crawler. Elle agit sur l'indexation, pas sur l'exploration ni sur l'accès : un visiteur qui possède l'URL consulte la page normalement.

Google traite noindex comme une directive, pas comme une suggestion. Dès qu'il crawle la page et lit l'instruction, il la retire de l'index ou ne l'y fait jamais entrer. C'est ce qui la distingue du canonical, qui n'est qu'un signal parmi d'autres.

Deux façons de la déclarer : meta robots et X-Robots-Tag

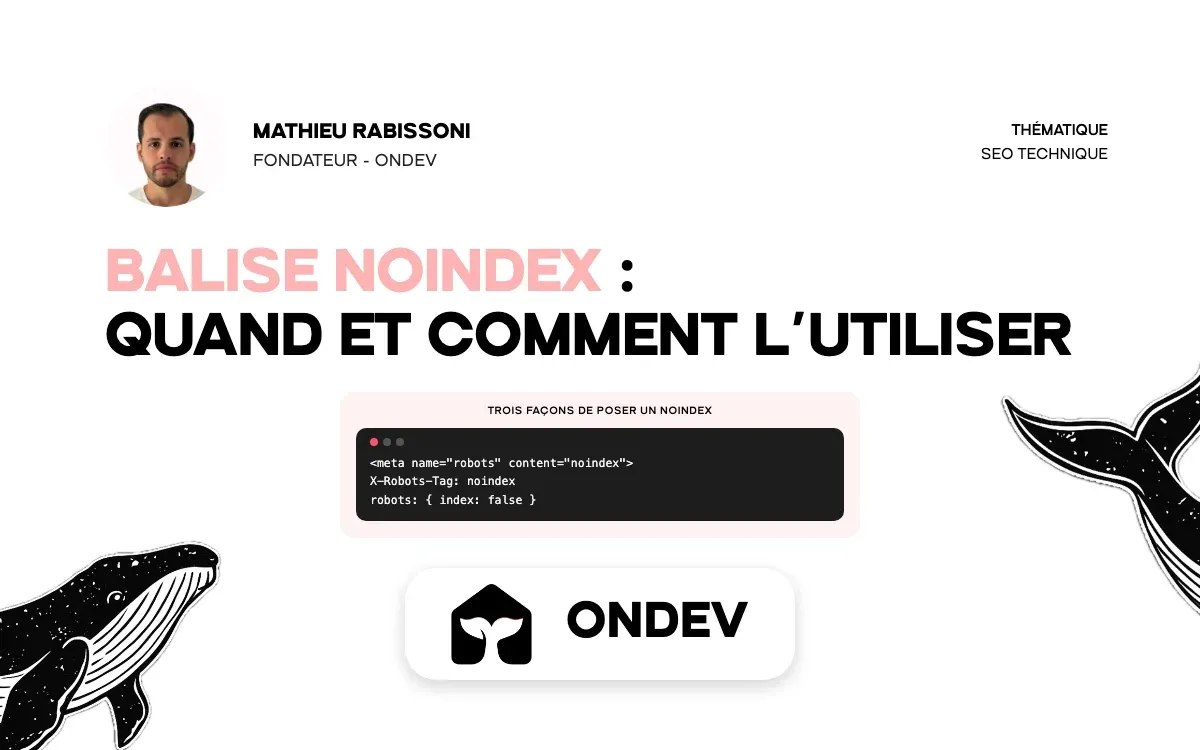
La forme la plus courante est la meta robots noindex, placée dans le <head> du document HTML :

html
<meta name="robots" content="noindex">

La seconde est l'en-tête HTTP X-Robots-Tag, envoyé par le serveur avant le contenu :

X-Robots-Tag: noindex

L'en-tête HTTP est indispensable pour les ressources sans <head> (PDF, images, exports) et plus pratique pour couvrir un répertoire ou un sous-domaine entier. Avec Next.js, le champ robots de l'objet metadata génère la balise meta, et un middleware peut poser l'en-tête sur tout un environnement.

noindex, nofollow, noindex nofollow : trois consignes différentes

La confusion la plus fréquente concerne le couple noindex nofollow. Les deux directives n'ont rien à voir :

  • •noindex : ne pas afficher cette page dans les résultats
  • •nofollow : ne pas suivre les liens de cette page, ni leur transmettre de popularité
  • •noindex, nofollow : les deux à la fois

Dans l'immense majorité des cas, vous voulez noindex seul. Une page de remerciement en noindex continue de linker vers vos pages de service : autant que Google suive ces liens. Poser nofollow par réflexe coupe une partie de votre maillage interne pour rien. Nuance : Google a indiqué qu'une page laissée longtemps en noindex finit par être traitée comme un noindex, nofollow, parce qu'elle est crawlée de moins en moins souvent.

Noindex, robots.txt, canonical, 410 : quatre outils, quatre problèmes

Ces quatre mécanismes sont confondus parce qu'ils produisent, de loin, le même effet apparent : la page « disparaît » de Google. En réalité, chacun répond à une question différente.

OutilCe qu'il dit à GoogleAccessible aux visiteursCrawléeCas d'usage
Balise noindex« Crawle-la, mais ne l'affiche pas »OuiOuiPage utile aux humains, inutile dans les résultats
robots.txt« Ne crawle pas cette zone »OuiNonÉconomiser le budget de crawl sur des URL sans valeur
Canonical« La version de référence est ailleurs »OuiOuiContenu dupliqué à consolider sur une URL unique
410 Gone« Cette page n'existe plus »NonOui, puis abandonContenu supprimé sans remplacement
Deux lignes méritent une insistance.

Le robots.txt n'est pas un outil de désindexation. Il empêche le crawl, pas l'indexation. Une URL bloquée dans robots.txt mais linkée depuis l'extérieur peut parfaitement apparaître dans les résultats, avec un extrait vide et le message « Aucune information n'est disponible pour cette page ». Google connaît l'URL grâce aux liens ; il n'a simplement pas le droit d'en lire le contenu.

Le canonical ne désindexe rien. C'est un signal de consolidation que Google peut ignorer si les deux pages sont trop différentes ou si d'autres signaux pointent ailleurs. Notre guide sur la balise canonical et le contenu dupliqué détaille les situations où il consolide et celles où il est ignoré.

Pourquoi bloquer dans robots.txt empêche Google de voir le noindex

C'est l'erreur la plus répandue, et elle est contre-intuitive : beaucoup de propriétaires de sites posent à la fois un noindex sur une page et un blocage dans robots.txt, en pensant « ceinture et bretelles ». Résultat : l'inverse de ce qu'ils voulaient.

Pour lire une balise noindex, Google doit télécharger la page. Si robots.txt lui interdit d'y accéder, il ne télécharge rien, donc il ne lit jamais la directive. La page reste dans l'index telle qu'il la connaissait, ou y entre via des liens externes, sans que Google puisse jamais constater qu'elle demande à en sortir.

La règle à retenir : noindex et Disallow sont incompatibles sur une même URL. Si vous voulez désindexer, laissez le crawl ouvert jusqu'à ce que la page ait disparu des résultats. Ensuite seulement, bloquez le crawl si la zone n'a vraiment aucune valeur.

À lire aussi : Sitemap XML et robots.txt : guide SEO - Ce que le fichier robots.txt contrôle réellement, et pourquoi il ne faut jamais lui demander ce qu'il ne sait pas faire.

L'arbre de décision : quel outil pour quel cas

Avant de toucher au code, répondez à trois questions dans l'ordre. Chaque réponse ferme des portes.

Question 1 : la page doit-elle continuer d'exister pour les visiteurs ?

  • •Non, elle est supprimée sans remplacement : renvoyez un code 410 Gone (ou à défaut un 404 propre). Si une page équivalente existe ailleurs, préférez une redirection 301 vers elle.
  • •Oui : passez à la question 2.

Question 2 : son contenu existe-t-il déjà sur une autre URL que vous préférez voir ranker ?

  • •Oui, c'est une variante (paramètre de tri, version imprimable, même fiche sous deux chemins) : posez un canonical vers l'URL de référence. Ne la désindexez pas, vous perdriez la consolidation des signaux.
  • •Non, elle est unique : passez à la question 3.

Question 3 : cette page a-t-elle un intérêt pour quelqu'un qui arrive depuis Google ?

  • •Non (page de remerciement, étape de tunnel, recherche interne, environnement de test) : c'est le territoire de la balise noindex.
  • •Oui, mais elle est mal positionnée : le problème n'est pas d'indexation. Travaillez le contenu et le maillage. Désindexer une page faible ne renforce pas les autres.

Et le robots.txt ? Il n'apparaît dans aucune branche, et c'est volontaire : il sert uniquement à économiser le budget de crawl sur des zones sans valeur et sans lien externe. Si vous cherchez à faire sortir une URL précise des résultats, notre guide pour supprimer une page de Google couvre aussi l'outil de suppression temporaire de la Search Console, utile pour gagner du temps en cas d'urgence.

Les cas d'usage légitimes de la balise noindex

Le noindex est fait pour des pages qui ont une raison d'exister sans avoir de raison d'être trouvées. Voici les principaux cas, dans l'ordre de fréquence que nous rencontrons en audit.

Les pages de remerciement et de confirmation

La page affichée après un formulaire, une inscription ou une commande. Indispensable au parcours, mais si elle est indexée, elle fausse vos conversions : des visiteurs arrivent dessus depuis Google et déclenchent vos objectifs analytics sans rien avoir envoyé.

Les pages de capture et landing pages dédiées

C'est une pratique que nous appliquons systématiquement chez ONDEV : les pages de capture (téléchargement d'un livre blanc, inscription à un atelier, landing page de campagne) sont volontairement maintenues hors index. La raison est stratégique. Ces pages portent souvent les mêmes expressions que les articles de blog qui ciblent la requête. Si Google indexe les deux, il doit choisir entre une page courte faite pour convertir et un article complet fait pour ranker. Il choisit parfois mal, et les deux pages se cannibalisent.

En réservant l'index à l'article, puis en faisant pointer l'article vers la page de capture, chaque page joue son rôle : l'une capte la requête, l'autre convertit le trafic qu'on lui envoie.

Les filtres, tris et facettes

Un catalogue avec dix filtres combinables génère des milliers d'URL pour quelques dizaines de contenus réels. Deux stratégies coexistent :

  • •Canonical vers la catégorie non filtrée quand la combinaison ne fait que réordonner ou restreindre la même liste
  • •Noindex quand les combinaisons produisent des pages distinctes mais sans intérêt de recherche (tri par prix, filtre « en stock »)

Gardez indexables les facettes qui correspondent à une vraie intention de recherche : « chaussures de running femme » mérite une page, « chaussures triées par nouveauté » non.

Les environnements de test et de préproduction

Un site de staging indexé entre en concurrence avec la production, et des URL de test fuient dans les résultats. La bonne pratique combine une authentification HTTP et un en-tête X-Robots-Tag: noindex posé par le middleware sur tout le domaine de préproduction. Sur Vercel, la protection par mot de passe des déploiements de prévisualisation fait ce barrage.

Ajoutez à cette liste les pages utilitaires : résultats de la recherche interne, pages « mon compte », paniers, versions imprimables. Utiles pendant la navigation, inutiles dans l'index.

Les erreurs qui désindexent un site entier

Les incidents graves que nous voyons en audit ne viennent presque jamais d'une page mal choisie. Ils viennent d'une règle globale posée au mauvais moment ou au mauvais niveau.

1. Le noindex de préproduction qui part en production. L'incident numéro un. Le site a été développé avec un noindex global pour protéger le staging, et la mise en production oublie de le retirer. Sur Next.js, le piège typique est une variable d'environnement qui pilote robots: { index: false } et qui n'a pas été redéfinie en production. Le site vit, et Google désindexe page après page.

2. La case « demander aux moteurs de ne pas indexer ce site » restée cochée. L'équivalent WordPress du cas précédent.

3. Noindex et Disallow sur les mêmes URL. Google ne peut pas lire une directive sur une page qu'il n'a pas le droit de crawler. La désindexation n'a jamais lieu.

4. Une règle de modèle trop large. Le noindex est posé sur un template sans vérifier ce qu'il couvre, et des catégories qui rankaient disparaissent avec les étiquettes.

5. Désindexer des pages qui portent des backlinks. Le noindex ne redistribue pas la popularité des liens externes. Si la page n'a plus de raison d'être, une redirection 301 vers la page la plus proche conserve cette valeur ; le noindex la gaspille.

6. Croire que le noindex est immédiat. Google ne lit la directive qu'au prochain crawl. Pour une page profonde, la désindexation peut prendre plusieurs semaines. En cas d'urgence (données personnelles exposées), l'outil de suppression de la Search Console agit en quelques heures, le noindex rendant ensuite le retrait durable.

7. Laisser des pages noindex dans le sitemap XML. Signal contradictoire : vous demandez à Google d'indexer une page qui lui dit le contraire. Un sitemap propre ne contient que des URL indexables, canoniques et en code 200.

Comment vérifier que Google a pris le noindex en compte

Poser la balise est la moitié du travail. L'autre moitié consiste à vérifier qu'elle est bien servie, puis qu'elle a été lue.

Vérifier que la directive est bien servie

Trois contrôles, du plus simple au plus complet :

  1. 1.Afficher le code source et chercher name="robots". Si la balise est injectée par JavaScript côté client, elle peut être absente du HTML initial, et Google ne la verra qu'au rendu.
  2. 2.Inspecter les en-têtes HTTP avec curl -I sur l'URL et chercher une ligne X-Robots-Tag. C'est le seul moyen de voir une directive posée côté serveur.
  3. 3.Lancer un crawl avec Screaming Frog et filtrer la colonne « Indexability » : vous repérez immédiatement une règle trop large ou une page stratégique passée en « Non-Indexable ».

Les deux premiers contrôles s'imposent après chaque mise en production, le troisième à chaque refonte.

Vérifier que Google l'a lue

Dans la Google Search Console, l'inspection d'URL indique l'état d'indexation et sa raison. Pour un noindex pris en compte, vous lirez « Exclue par la balise noindex ». Le bouton « Tester l'URL en direct » force une récupération immédiate et montre ce que Googlebot voit aujourd'hui, directive incluse.

Le rapport Pages agrège la même information à l'échelle du site. La ligne « Exclue par la balise noindex » doit correspondre à votre liste de pages volontairement exclues. Si vous y trouvez une page de service ou un article, vous tenez votre incident.

Pour comprendre l'ensemble du cycle, de la découverte à l'affichage, notre article sur l'indexation Google et le référencement détaille comment Google décide d'indexer une page, et ce qui ralentit la prise en compte des changements.

FAQ : vos questions sur la balise noindex

La balise noindex empêche-t-elle Google de crawler la page ?
Non. Le noindex n'agit que sur l'affichage dans les résultats. Google continue de crawler la page, c'est même indispensable pour qu'il lise la directive. Pour empêcher le crawl, c'est le robots.txt qui intervient, mais il ne désindexe rien. Les deux ne doivent jamais être combinés sur la même URL tant que la désindexation n'est pas effective.
Quelle différence entre noindex et nofollow ?
Le noindex concerne la page : ne pas l'afficher dans les résultats. Le nofollow concerne ses liens : ne pas les suivre ni leur transmettre de popularité. Dans la plupart des cas, un noindex seul suffit ; ajouter nofollow par réflexe coupe une partie de votre maillage interne pour rien.
Combien de temps faut-il pour qu'une page en noindex disparaisse de Google ?
Le temps que Google recrawle la page : quelques jours pour une page populaire, plusieurs semaines pour une page profonde. Vous pouvez accélérer en demandant une indexation depuis l'inspection d'URL de la Search Console, ou utiliser l'outil de suppression temporaire pour une urgence.
Noindex ou canonical pour mes pages de filtres ?
Si la page filtrée n'est qu'une réorganisation de la même liste, le canonical vers la catégorie principale consolide les signaux. Si elle produit un contenu distinct sans intérêt de recherche, le noindex est plus honnête. Si le filtre correspond à une vraie intention de recherche, gardez-la indexable et travaillez-la comme une page à part entière.

Ce qu'il faut retenir avant de toucher à une balise

La balise noindex n'est ni un bouton « supprimer » ni un outil de nettoyage de masse. C'est une réponse précise à une question précise : cette page doit-elle exister pour les humains sans exister pour Google ? Si oui, le noindex est le bon outil. Si la page est supprimée, c'est un 410. Si elle en duplique une autre, c'est un canonical. Et le robots.txt ne sert jamais à désindexer.

Le vrai risque n'est pas de mal choisir sur une page, c'est de poser une règle globale au mauvais moment. Un contrôle après chaque mise en production et une lecture régulière du rapport Pages écartent la quasi-totalité des incidents.


Votre site perd des pages dans l'index, ou vous ne savez pas lesquelles devraient en sortir ? Demandez un devis pour un audit SEO technique : nous passons en revue noindex, robots.txt, canonical et codes de réponse, et nous vous livrons un plan de correction priorisé.
Auteur

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

Infos

24 octobre 2026
12 mn
SEO

Service lié

Référencement SEO

1ère page Google pour vos mots-clés à Marseille.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

  • Sans dépendance technique
  • Sans frais de maintenance inutiles
On en discute ?

Avec nous c'est simple, rien n'est compliqué !

Nos réalisations

Refonte & SEO - Amadeus Centre d’Affaires
Refonte & Stratégie SEO

Refonte & SEO - Amadeus Centre d’Affaires

Wiloq - Application SaaS Vestiaire Numérique
Application SaaS

Wiloq - Application SaaS Vestiaire Numérique

Voir toutes les réalisations

Une seule ligne de code suffit à faire disparaître votre site de Google

La balise noindex est l'un des outils les plus puissants du SEO technique, et l'un des plus mal utilisés. Posée au bon endroit, elle concentre la visibilité sur les pages qui comptent. Oubliée après une mise en production, elle efface des mois de travail en quelques jours de crawl, sans que personne ne s'en aperçoive avant la chute du trafic.

Dans cet article, vous allez découvrir :

  • •Ce que fait exactement la balise noindex, et ce qu'elle ne fait pas (la confusion avec nofollow coûte cher)
  • •Pourquoi noindex, robots.txt, canonical et 410 répondent à quatre problèmes différents, avec un arbre de décision pour choisir sans hésiter
  • •Les cas d'usage légitimes, dont la pratique ONDEV sur les pages de capture
  • •Les erreurs qui désindexent un site entier, et pourquoi bloquer une page dans robots.txt empêche Google de voir votre noindex
  • •La méthode pour vérifier que Google a bien pris la consigne en compte
Désindexer n'est pas supprimer. Quatre outils, quatre intentions : si vous ne savez pas lequel choisir, vous n'avez pas encore identifié le problème.

Qu'est-ce que la balise noindex ? Définition nette

La balise noindex est une directive adressée aux moteurs de recherche qui leur demande de ne pas afficher une page dans leurs résultats, tout en les laissant libres de la crawler. Elle agit sur l'indexation, pas sur l'exploration ni sur l'accès : un visiteur qui possède l'URL consulte la page normalement.

Google traite noindex comme une directive, pas comme une suggestion. Dès qu'il crawle la page et lit l'instruction, il la retire de l'index ou ne l'y fait jamais entrer. C'est ce qui la distingue du canonical, qui n'est qu'un signal parmi d'autres.

Deux façons de la déclarer : meta robots et X-Robots-Tag

La forme la plus courante est la meta robots noindex, placée dans le <head> du document HTML :

html
<meta name="robots" content="noindex">

La seconde est l'en-tête HTTP X-Robots-Tag, envoyé par le serveur avant le contenu :

X-Robots-Tag: noindex

L'en-tête HTTP est indispensable pour les ressources sans <head> (PDF, images, exports) et plus pratique pour couvrir un répertoire ou un sous-domaine entier. Avec Next.js, le champ robots de l'objet metadata génère la balise meta, et un middleware peut poser l'en-tête sur tout un environnement.

noindex, nofollow, noindex nofollow : trois consignes différentes

La confusion la plus fréquente concerne le couple noindex nofollow. Les deux directives n'ont rien à voir :

  • •noindex : ne pas afficher cette page dans les résultats
  • •nofollow : ne pas suivre les liens de cette page, ni leur transmettre de popularité
  • •noindex, nofollow : les deux à la fois

Dans l'immense majorité des cas, vous voulez noindex seul. Une page de remerciement en noindex continue de linker vers vos pages de service : autant que Google suive ces liens. Poser nofollow par réflexe coupe une partie de votre maillage interne pour rien. Nuance : Google a indiqué qu'une page laissée longtemps en noindex finit par être traitée comme un noindex, nofollow, parce qu'elle est crawlée de moins en moins souvent.

Noindex, robots.txt, canonical, 410 : quatre outils, quatre problèmes

Ces quatre mécanismes sont confondus parce qu'ils produisent, de loin, le même effet apparent : la page « disparaît » de Google. En réalité, chacun répond à une question différente.

OutilCe qu'il dit à GoogleAccessible aux visiteursCrawléeCas d'usage
Balise noindex« Crawle-la, mais ne l'affiche pas »OuiOuiPage utile aux humains, inutile dans les résultats
robots.txt« Ne crawle pas cette zone »OuiNonÉconomiser le budget de crawl sur des URL sans valeur
Canonical« La version de référence est ailleurs »OuiOuiContenu dupliqué à consolider sur une URL unique
410 Gone« Cette page n'existe plus »NonOui, puis abandonContenu supprimé sans remplacement
Deux lignes méritent une insistance.

Le robots.txt n'est pas un outil de désindexation. Il empêche le crawl, pas l'indexation. Une URL bloquée dans robots.txt mais linkée depuis l'extérieur peut parfaitement apparaître dans les résultats, avec un extrait vide et le message « Aucune information n'est disponible pour cette page ». Google connaît l'URL grâce aux liens ; il n'a simplement pas le droit d'en lire le contenu.

Le canonical ne désindexe rien. C'est un signal de consolidation que Google peut ignorer si les deux pages sont trop différentes ou si d'autres signaux pointent ailleurs. Notre guide sur la balise canonical et le contenu dupliqué détaille les situations où il consolide et celles où il est ignoré.

Pourquoi bloquer dans robots.txt empêche Google de voir le noindex

C'est l'erreur la plus répandue, et elle est contre-intuitive : beaucoup de propriétaires de sites posent à la fois un noindex sur une page et un blocage dans robots.txt, en pensant « ceinture et bretelles ». Résultat : l'inverse de ce qu'ils voulaient.

Pour lire une balise noindex, Google doit télécharger la page. Si robots.txt lui interdit d'y accéder, il ne télécharge rien, donc il ne lit jamais la directive. La page reste dans l'index telle qu'il la connaissait, ou y entre via des liens externes, sans que Google puisse jamais constater qu'elle demande à en sortir.

La règle à retenir : noindex et Disallow sont incompatibles sur une même URL. Si vous voulez désindexer, laissez le crawl ouvert jusqu'à ce que la page ait disparu des résultats. Ensuite seulement, bloquez le crawl si la zone n'a vraiment aucune valeur.

À lire aussi : Sitemap XML et robots.txt : guide SEO - Ce que le fichier robots.txt contrôle réellement, et pourquoi il ne faut jamais lui demander ce qu'il ne sait pas faire.

L'arbre de décision : quel outil pour quel cas

Avant de toucher au code, répondez à trois questions dans l'ordre. Chaque réponse ferme des portes.

Question 1 : la page doit-elle continuer d'exister pour les visiteurs ?

  • •Non, elle est supprimée sans remplacement : renvoyez un code 410 Gone (ou à défaut un 404 propre). Si une page équivalente existe ailleurs, préférez une redirection 301 vers elle.
  • •Oui : passez à la question 2.

Question 2 : son contenu existe-t-il déjà sur une autre URL que vous préférez voir ranker ?

  • •Oui, c'est une variante (paramètre de tri, version imprimable, même fiche sous deux chemins) : posez un canonical vers l'URL de référence. Ne la désindexez pas, vous perdriez la consolidation des signaux.
  • •Non, elle est unique : passez à la question 3.

Question 3 : cette page a-t-elle un intérêt pour quelqu'un qui arrive depuis Google ?

  • •Non (page de remerciement, étape de tunnel, recherche interne, environnement de test) : c'est le territoire de la balise noindex.
  • •Oui, mais elle est mal positionnée : le problème n'est pas d'indexation. Travaillez le contenu et le maillage. Désindexer une page faible ne renforce pas les autres.

Et le robots.txt ? Il n'apparaît dans aucune branche, et c'est volontaire : il sert uniquement à économiser le budget de crawl sur des zones sans valeur et sans lien externe. Si vous cherchez à faire sortir une URL précise des résultats, notre guide pour supprimer une page de Google couvre aussi l'outil de suppression temporaire de la Search Console, utile pour gagner du temps en cas d'urgence.

Les cas d'usage légitimes de la balise noindex

Le noindex est fait pour des pages qui ont une raison d'exister sans avoir de raison d'être trouvées. Voici les principaux cas, dans l'ordre de fréquence que nous rencontrons en audit.

Les pages de remerciement et de confirmation

La page affichée après un formulaire, une inscription ou une commande. Indispensable au parcours, mais si elle est indexée, elle fausse vos conversions : des visiteurs arrivent dessus depuis Google et déclenchent vos objectifs analytics sans rien avoir envoyé.

Les pages de capture et landing pages dédiées

C'est une pratique que nous appliquons systématiquement chez ONDEV : les pages de capture (téléchargement d'un livre blanc, inscription à un atelier, landing page de campagne) sont volontairement maintenues hors index. La raison est stratégique. Ces pages portent souvent les mêmes expressions que les articles de blog qui ciblent la requête. Si Google indexe les deux, il doit choisir entre une page courte faite pour convertir et un article complet fait pour ranker. Il choisit parfois mal, et les deux pages se cannibalisent.

En réservant l'index à l'article, puis en faisant pointer l'article vers la page de capture, chaque page joue son rôle : l'une capte la requête, l'autre convertit le trafic qu'on lui envoie.

Les filtres, tris et facettes

Un catalogue avec dix filtres combinables génère des milliers d'URL pour quelques dizaines de contenus réels. Deux stratégies coexistent :

  • •Canonical vers la catégorie non filtrée quand la combinaison ne fait que réordonner ou restreindre la même liste
  • •Noindex quand les combinaisons produisent des pages distinctes mais sans intérêt de recherche (tri par prix, filtre « en stock »)

Gardez indexables les facettes qui correspondent à une vraie intention de recherche : « chaussures de running femme » mérite une page, « chaussures triées par nouveauté » non.

Les environnements de test et de préproduction

Un site de staging indexé entre en concurrence avec la production, et des URL de test fuient dans les résultats. La bonne pratique combine une authentification HTTP et un en-tête X-Robots-Tag: noindex posé par le middleware sur tout le domaine de préproduction. Sur Vercel, la protection par mot de passe des déploiements de prévisualisation fait ce barrage.

Ajoutez à cette liste les pages utilitaires : résultats de la recherche interne, pages « mon compte », paniers, versions imprimables. Utiles pendant la navigation, inutiles dans l'index.

Les erreurs qui désindexent un site entier

Les incidents graves que nous voyons en audit ne viennent presque jamais d'une page mal choisie. Ils viennent d'une règle globale posée au mauvais moment ou au mauvais niveau.

1. Le noindex de préproduction qui part en production. L'incident numéro un. Le site a été développé avec un noindex global pour protéger le staging, et la mise en production oublie de le retirer. Sur Next.js, le piège typique est une variable d'environnement qui pilote robots: { index: false } et qui n'a pas été redéfinie en production. Le site vit, et Google désindexe page après page.

2. La case « demander aux moteurs de ne pas indexer ce site » restée cochée. L'équivalent WordPress du cas précédent.

3. Noindex et Disallow sur les mêmes URL. Google ne peut pas lire une directive sur une page qu'il n'a pas le droit de crawler. La désindexation n'a jamais lieu.

4. Une règle de modèle trop large. Le noindex est posé sur un template sans vérifier ce qu'il couvre, et des catégories qui rankaient disparaissent avec les étiquettes.

5. Désindexer des pages qui portent des backlinks. Le noindex ne redistribue pas la popularité des liens externes. Si la page n'a plus de raison d'être, une redirection 301 vers la page la plus proche conserve cette valeur ; le noindex la gaspille.

6. Croire que le noindex est immédiat. Google ne lit la directive qu'au prochain crawl. Pour une page profonde, la désindexation peut prendre plusieurs semaines. En cas d'urgence (données personnelles exposées), l'outil de suppression de la Search Console agit en quelques heures, le noindex rendant ensuite le retrait durable.

7. Laisser des pages noindex dans le sitemap XML. Signal contradictoire : vous demandez à Google d'indexer une page qui lui dit le contraire. Un sitemap propre ne contient que des URL indexables, canoniques et en code 200.

Comment vérifier que Google a pris le noindex en compte

Poser la balise est la moitié du travail. L'autre moitié consiste à vérifier qu'elle est bien servie, puis qu'elle a été lue.

Vérifier que la directive est bien servie

Trois contrôles, du plus simple au plus complet :

  1. 1.Afficher le code source et chercher name="robots". Si la balise est injectée par JavaScript côté client, elle peut être absente du HTML initial, et Google ne la verra qu'au rendu.
  2. 2.Inspecter les en-têtes HTTP avec curl -I sur l'URL et chercher une ligne X-Robots-Tag. C'est le seul moyen de voir une directive posée côté serveur.
  3. 3.Lancer un crawl avec Screaming Frog et filtrer la colonne « Indexability » : vous repérez immédiatement une règle trop large ou une page stratégique passée en « Non-Indexable ».

Les deux premiers contrôles s'imposent après chaque mise en production, le troisième à chaque refonte.

Vérifier que Google l'a lue

Dans la Google Search Console, l'inspection d'URL indique l'état d'indexation et sa raison. Pour un noindex pris en compte, vous lirez « Exclue par la balise noindex ». Le bouton « Tester l'URL en direct » force une récupération immédiate et montre ce que Googlebot voit aujourd'hui, directive incluse.

Le rapport Pages agrège la même information à l'échelle du site. La ligne « Exclue par la balise noindex » doit correspondre à votre liste de pages volontairement exclues. Si vous y trouvez une page de service ou un article, vous tenez votre incident.

Pour comprendre l'ensemble du cycle, de la découverte à l'affichage, notre article sur l'indexation Google et le référencement détaille comment Google décide d'indexer une page, et ce qui ralentit la prise en compte des changements.

FAQ : vos questions sur la balise noindex

La balise noindex empêche-t-elle Google de crawler la page ?
Non. Le noindex n'agit que sur l'affichage dans les résultats. Google continue de crawler la page, c'est même indispensable pour qu'il lise la directive. Pour empêcher le crawl, c'est le robots.txt qui intervient, mais il ne désindexe rien. Les deux ne doivent jamais être combinés sur la même URL tant que la désindexation n'est pas effective.
Quelle différence entre noindex et nofollow ?
Le noindex concerne la page : ne pas l'afficher dans les résultats. Le nofollow concerne ses liens : ne pas les suivre ni leur transmettre de popularité. Dans la plupart des cas, un noindex seul suffit ; ajouter nofollow par réflexe coupe une partie de votre maillage interne pour rien.
Combien de temps faut-il pour qu'une page en noindex disparaisse de Google ?
Le temps que Google recrawle la page : quelques jours pour une page populaire, plusieurs semaines pour une page profonde. Vous pouvez accélérer en demandant une indexation depuis l'inspection d'URL de la Search Console, ou utiliser l'outil de suppression temporaire pour une urgence.
Noindex ou canonical pour mes pages de filtres ?
Si la page filtrée n'est qu'une réorganisation de la même liste, le canonical vers la catégorie principale consolide les signaux. Si elle produit un contenu distinct sans intérêt de recherche, le noindex est plus honnête. Si le filtre correspond à une vraie intention de recherche, gardez-la indexable et travaillez-la comme une page à part entière.

Ce qu'il faut retenir avant de toucher à une balise

La balise noindex n'est ni un bouton « supprimer » ni un outil de nettoyage de masse. C'est une réponse précise à une question précise : cette page doit-elle exister pour les humains sans exister pour Google ? Si oui, le noindex est le bon outil. Si la page est supprimée, c'est un 410. Si elle en duplique une autre, c'est un canonical. Et le robots.txt ne sert jamais à désindexer.

Le vrai risque n'est pas de mal choisir sur une page, c'est de poser une règle globale au mauvais moment. Un contrôle après chaque mise en production et une lecture régulière du rapport Pages écartent la quasi-totalité des incidents.


Votre site perd des pages dans l'index, ou vous ne savez pas lesquelles devraient en sortir ? Demandez un devis pour un audit SEO technique : nous passons en revue noindex, robots.txt, canonical et codes de réponse, et nous vous livrons un plan de correction priorisé.

Mathieu Rabissoni

Mathieu Rabissoni

Expert Web

24 octobre 2026
12 mn
SEO

Service lié

Référencement SEO

1ère page Google pour vos mots-clés à Marseille.

Découvrir

Travailler avec ONDEV

On construit pour vous un site sur mesure, adapté à vos enjeux business.

On en discute ?
Mathieu Rabissoni

Mathieu Rabissoni

Expert Acquisition Client Digitale

Passionné par le web depuis toujours, j'aide les entreprises à acquérir des clients grâce au digital. Sites web, applications, SEO : je transforme vos idées en solutions performantes.

En savoir plus

Services ONDEV liés à cet article

Référencement SEO Marseille•Consultant SEO Marseille•Optimisation GEO & IA•Site internet optimisé SEO•Guide Google My Business•Nos réalisations

Besoin d'aide pour votre projet ?

Discutons de vos objectifs et voyons comment je peux vous aider à les atteindre.

Prendre rendez-vousAppelerWhatsApp